
使用BERT在Kaggle上使用NLP入门
来源:dev.to
2025-01-30 18:15:20
0浏览
收藏
一分耕耘,一分收获!既然都打开这篇《使用BERT在Kaggle上使用NLP入门》,就坚持看下去,学下去吧!本文主要会给大家讲到等等知识点,如果大家对本文有好的建议或者看到有不足之处,非常欢迎大家积极提出!在后续文章我会继续更新文章相关的内容,希望对大家都有所帮助!
1,进口和eda
import os
iskaggle = os.environ.get('kaggle_kernel_run_type', '')
from pathlib import path
if iskaggle:
    path = path('/kaggle/input/us-patent-phrase-to-phrase-matching')
import pandas as pd
df = pd.read_csv(path/'train.csv')
df['input'] = 'text1: ' + df.context + '; text2: ' + df.target + '; anc1: ' + df.anchor
df.input.head()
2,令牌化
from datasets import dataset, datasetdict
ds = dataset.from_pandas(df)
import warnings,logging,torch
warnings.simplefilter('ignore')
logging.disable(logging.warning)
model_nm = 'anferico/bert-for-patents'
# load model directly
from transformers import automodelforsequenceclassification, autotokenizer
model = automodelforsequenceclassification.from_pretrained(model_nm, num_labels=1)
tokenizer = autotokenizer.from_pretrained('anferico/bert-for-patents')
def tok_func(x):
    return tokenizer(x['input'])
# tokenize all the sentences using the tokenizer
tok_ds = ds.map(tok_func, batched=true)
tok_ds = tok_ds.rename_columns({'score':'labels'})
3,测试和验证集
eval_df = pd.read_csv(path/'test.csv')
dds = tok_ds.train_test_split(0.25, seed=42)
eval_df['input'] = 'text1: ' + eval_df.context + '; text2: ' + eval_df.target + '; anc1: ' + eval_df.anchor
eval_ds = dataset.from_pandas(eval_df).map(tok_func, batched=true)
4,指标和相关性
import numpy as np
def corr(x,y):
    ## change the 2-d array into 1-d array
    return np.corrcoef(x.flatten(), y)[0,1]
def corr_d(eval_pred): return {'pearson': corr(*eval_pred)}
5,训练我们的模型
14625233945
6,在测试集中获取预测
preds = trainer.predict(eval_ds).predictions.astype(float)
preds = np.clip(preds, 0, 1)
import datasets

submission = datasets.Dataset.from_dict({
    'id': eval_ds['id'],
    'score': preds
})

submission.to_csv('submission.csv', index=False)
今天关于《使用BERT在Kaggle上使用NLP入门》的内容介绍就到此结束,如果有什么疑问或者建议,可以在golang学习网公众号下多多回复交流;文中若有不正之处,也希望回复留言以告知!
版本声明
本文转载于:dev.to 如有侵犯,请联系study_golang@163.com删除
 川普出席佛罗里达州度假会议:计划对输入美国的多种商品课征全面关税
- 上一篇
- 川普出席佛罗里达州度假会议:计划对输入美国的多种商品课征全面关税

- 下一篇
- 功能测试工具:为您的项目选择合适的一个
查看更多
最新文章
-
- 文章 · python教程 | 9小时前 | python · Python decimal compare_total 全序比较
- Python Decimal.compare_total 怎样区分数值相等的不同表示
- 331浏览 收藏
-
- 文章 · python教程 | 10小时前 |
- Python AST 怎样提取节点对应的原始源码片段
- 261浏览 收藏
-
- 文章 · python教程 | 10小时前 | python · 类型系统 · Python types.resolve_bases __mro_entries__
- Python types.resolve_bases 怎样展开动态基类占位对象
- 108浏览 收藏
-
- 文章 · python教程 | 10小时前 | Python SQLite sqlite3 getlimit Connection.setlimit
- Python sqlite3.Connection.setlimit 怎样限制单个连接的资源上限
- 247浏览 收藏
-
- 文章 · python教程 | 10小时前 | SQLite · Python教程 · Python SQLite sqlite3 complete_statement 多语句脚本 CREATE TRIGGER
- Python sqlite3.complete_statement 判断多语句输入完整性的处理方案
- 140浏览 收藏
-
- 文章 · python教程 | 10小时前 | python · pathlib · Python pathlib walk_up relative_to
- Python pathlib.relative_to 怎样避免无关路径抛错
- 256浏览 收藏
-
- 文章 · python教程 | 10小时前 | python · Python Property 描述符 inspect.getattr_static 静态属性读取
- Python 怎样读取属性定义而不触发 property
- 299浏览 收藏
-
- 文章 · python教程 | 11小时前 | 依赖管理 · 故障排查 · Python教程 · Python importlib.metadata packages_distributions 发行包 导入名
- Python 怎样根据导入名查询对应的发行包
- 138浏览 收藏
-
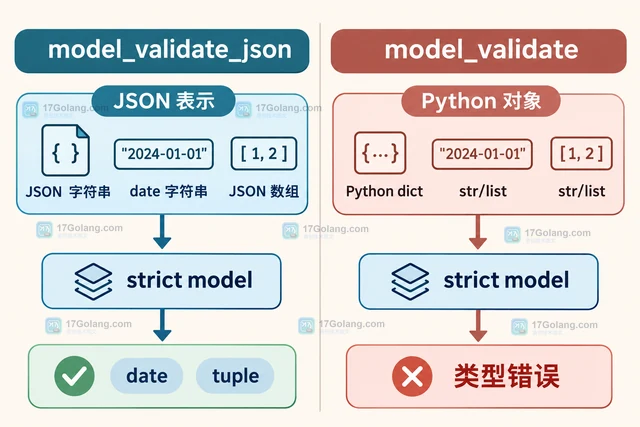
- 文章 · python教程 | 11小时前 | 数据校验 · Python教程 · Python Pydantic JSON校验 model_validate_json strict mode
- Pydantic model_validate_json 怎样在严格模式下解析请求体
- 417浏览 收藏
查看更多
课程推荐
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
查看更多
AI推荐
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 1064次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 1063次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1230次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1173次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 1013次使用
查看更多
相关文章
-
- Python TaskGroup 怎样让子任务失败统一收敛
- 2026-11-12 501浏览
-
- Python xml.dom.minidom.unlink 怎样释放不再使用的 DOM 树引用
- 2026-10-27 501浏览
-
- Python typing 怎样用 TypeIs 缩小类型
- 2026-10-24 501浏览
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览


