
使用 OpenAI、Go 和 PostgreSQL (pgvector) 构建语义搜索引擎
2025-01-20 15:00:53
0浏览
收藏
一分耕耘,一分收获!既然都打开这篇《使用 OpenAI、Go 和 PostgreSQL (pgvector) 构建语义搜索引擎》,就坚持看下去,学下去吧!本文主要会给大家讲到等等知识点,如果大家对本文有好的建议或者看到有不足之处,非常欢迎大家积极提出!在后续文章我会继续更新Golang相关的内容,希望对大家都有所帮助!

近年来,向量嵌入技术已成为自然语言处理(NLP)和语义搜索的核心。与传统的关键词搜索不同,向量数据库通过比较文本的向量表示(嵌入)来理解文本的语义含义。本示例展示如何结合OpenAI嵌入、Go语言和PostgreSQL数据库(以及pgvector扩展)构建一个语义搜索引擎。
什么是嵌入?
嵌入是文本(或其他数据)在高维空间中的向量表示。语义相似的文本在该空间中具有相近的向量。将嵌入存储在PostgreSQL(使用pgvector扩展)等数据库中,可以实现快速准确的相似性搜索。
为什么PostgreSQL使用pgvector?
pgvector是一个流行的PostgreSQL扩展,它添加了向量数据类型,支持:
- 存储嵌入作为向量列
- 执行近似或精确最近邻搜索
- 使用标准SQL进行查询
应用程序概述
- 调用OpenAI的嵌入API将输入文本转换为向量嵌入。
- 使用pgvector扩展将这些嵌入存储在PostgreSQL数据库中。
- 查询嵌入以查找数据库中最语义相似的条目。
先决条件
- Go语言安装(推荐1.19版本)。
- 本地或云端部署并运行的PostgreSQL数据库。
- 在PostgreSQL中安装pgvector扩展。(安装说明请参考pgvector的GitHub页面。)
- 可访问OpenAI API密钥。
Makefile用于本地测试,包含PostgreSQL/pgvector和Docker相关任务:
pgvector:
    @docker run -d \
        --name pgvector \
        -e postgres_user=admin \
        -e postgres_password=admin \
        -e postgres_db=vectordb \
        -v pgvector_data:/var/lib/postgresql/data \
        -p 5432:5432 \
        pgvector/pgvector:pg17
psql:
    @psql -h localhost -u admin -d vectordb
确保已安装pgvector。然后在PostgreSQL数据库中执行:
create extension if not exists vector;完整代码
package main

import (
    "context"
    "fmt"
    "log"
    "os"
    "strings"

    "github.com/jackc/pgx/v5/pgxpool"
    "github.com/joho/godotenv"
    "github.com/sashabaranov/go-openai"
)

func floats32ToString(floats []float32) string {
    strVals := make([]string, len(floats))
    for i, val := range floats {
        strVals[i] = fmt.Sprintf("%f", val)
    }
    joined := strings.Join(strVals, ", ")
    return "[" + joined + "]"
}

func main() {
    err := godotenv.Load()
    if err != nil {
        log.Fatal("Error loading .env file")
    }

    dbpool, err := pgxpool.New(context.Background(), os.Getenv("DATABASE_URL"))
    if err != nil {
        fmt.Fprintf(os.Stderr, "Unable to create connection pool: %v\n", err)
        os.Exit(1)
    }
    defer dbpool.Close()

    _, err = dbpool.Exec(context.Background(), "CREATE EXTENSION IF NOT EXISTS vector;")
    if err != nil {
        log.Fatalf("Failed to create extension: %v\n", err)
        os.Exit(1)
    }

    createTableSQL := `
    CREATE TABLE IF NOT EXISTS documents (
        id SERIAL PRIMARY KEY,
        content TEXT,
        embedding vector(1536)
    );
    `
    _, err = dbpool.Exec(context.Background(), createTableSQL)
    if err != nil {
        log.Fatalf("Failed to create table: %v\n", err)
    }

    createIndexSQL := `
    CREATE INDEX IF NOT EXISTS documents_embedding_idx
    ON documents USING ivfflat (embedding vector_l2_ops) WITH (lists = 100);
    `
    _, err = dbpool.Exec(context.Background(), createIndexSQL)
    if err != nil {
        log.Fatalf("Failed to create index: %v\n", err)
    }

    apiKey := os.Getenv("OPENAI_API_KEY")
    if apiKey == "" {
        log.Fatal("OPENAI_API_KEY is not set")
    }
    openaiClient := openai.NewClient(apiKey)

    docs := []string{
        "PostgreSQL is an advanced open-source relational database.",
        "OpenAI provides GPT-based models to generate text embeddings.",
        "pgvector allows storing embeddings in a Postgres database.",
    }

    for _, doc := range docs {
        err = insertDocument(context.Background(), dbpool, openaiClient, doc)
        if err != nil {
            log.Printf("Failed to insert document '%s': %v\n", doc, err)
        }
    }

    queryText := "How to store embeddings in Postgres?"
    similarDocs, err := searchSimilarDocuments(context.Background(), dbpool, openaiClient, queryText, 5)
    if err != nil {
        log.Fatalf("Search failed: %v\n", err)
    }

    fmt.Println("=== Most Similar Documents ===")
    for _, doc := range similarDocs {
        fmt.Printf("- %s\n", doc)
    }
}

func insertDocument(ctx context.Context, dbpool *pgxpool.Pool, client *openai.Client, content string) error {
    embedResp, err := client.CreateEmbeddings(ctx, openai.EmbeddingRequest{
        Model: openai.AdaEmbeddingV2,
        Input: []string{content},
    })
    if err != nil {
        return fmt.Errorf("CreateEmbeddings API call failed: %w", err)
    }

    embedding := embedResp.Data[0].Embedding
    embeddingStr := floats32ToString(embedding)

    insertSQL := `
        INSERT INTO documents (content, embedding)
        VALUES ($1, $2::vector)
    `
    _, err = dbpool.Exec(ctx, insertSQL, content, embeddingStr)
    if err != nil {
        return fmt.Errorf("failed to insert document: %w", err)
    }

    return nil
}

func searchSimilarDocuments(ctx context.Context, pool *pgxpool.Pool, client *openai.Client, query string, k int) ([]string, error) {
    embedResp, err := client.CreateEmbeddings(ctx, openai.EmbeddingRequest{
        Model: openai.AdaEmbeddingV2,
        Input: []string{query},
    })
    if err != nil {
        return nil, fmt.Errorf("CreateEmbeddings API call failed: %w", err)
    }

    queryEmbedding := embedResp.Data[0].Embedding
    queryEmbeddingStr := floats32ToString(queryEmbedding)

    selectSQL := fmt.Sprintf(`
        SELECT content
        FROM documents
        ORDER BY embedding <-> '%s'::vector
        LIMIT %d;
    `, queryEmbeddingStr, k)

    rows, err := pool.Query(ctx, selectSQL)
    if err != nil {
        return nil, fmt.Errorf("failed to query documents: %w", err)
    }
    defer rows.Close()

    var contents []string
    for rows.Next() {
        var content string
        if err := rows.Scan(&content); err != nil {
            return nil, fmt.Errorf("failed to scan row: %w", err)
        }
        contents = append(contents, content)
    }
    if err = rows.Err(); err != nil {
        return nil, fmt.Errorf("row iteration error: %w", err)
    }

    return contents, nil
}
结论
OpenAI嵌入、Go语言和PostgreSQL数据库中的pgvector扩展提供了一种简便的语义搜索引擎构建方案。通过将文本表示为向量并利用数据库索引的优势,我们实现了从传统的基于关键词的搜索到基于语义理解的搜索的转变。
理论要掌握,实操不能落!以上关于《使用 OpenAI、Go 和 PostgreSQL (pgvector) 构建语义搜索引擎》的详细介绍,大家都掌握了吧!如果想要继续提升自己的能力,那么就来关注golang学习网公众号吧!
 总规模5亿元,常州经开产业基金完成私募投资基金备案
- 上一篇
- 总规模5亿元,常州经开产业基金完成私募投资基金备案

- 下一篇
- Ubuntu9.04太多乱码(中文不能正常显示)
查看更多
最新文章
-
- Golang · Go教程 | 2天前 | go · testing ·
- Go Benchmark报告allocs/op并定位临时对象来源的方法
- 409浏览 收藏
-
- Golang · Go教程 | 2天前 |
- Go fuzz测试把崩溃输入写入回归语料的流程
- 195浏览 收藏
-
- Golang · Go教程 | 2天前 |
- Go testing.T.TempDir管理测试临时文件的清理方法
- 308浏览 收藏
-
- Golang · Go教程 | 2天前 | 日志 · go · slog · Go 结构化日志 log/slog slog.Group
- Go log/slog用Group组织结构化日志字段的实现方式
- 367浏览 收藏
-
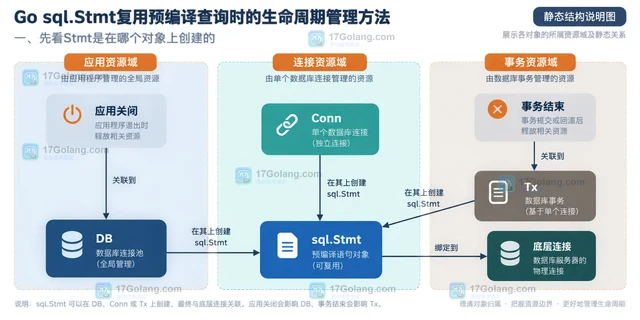
- Golang · Go教程 | 2天前 | 资源管理 · Go教程 · database/sql · Go 生命周期 database/sql sql.Stmt 预编译查询
- Go sql.Stmt复用预编译查询时的生命周期管理方法
- 465浏览 收藏
-
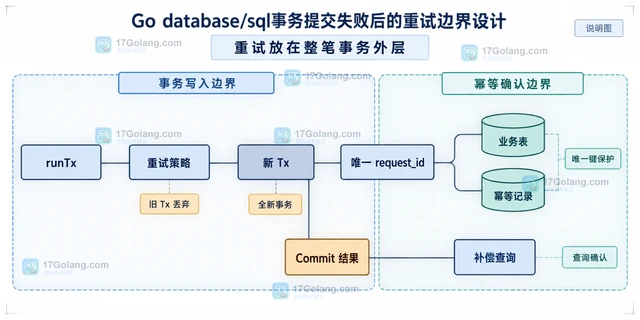
- Golang · Go教程 | 2天前 | 事务 · go · database/sql · 重试 事务提交 database/sql 幂等键
- Go database/sql事务提交失败后的重试边界设计
- 429浏览 收藏
-
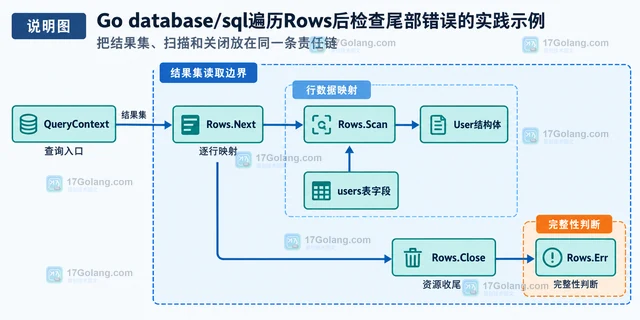
- Golang · Go教程 | 2天前 | 错误处理 · go · 数据库 · database/sql rows Rows.Err
- Go database/sql遍历Rows后检查尾部错误的实践示例
- 203浏览 收藏
-
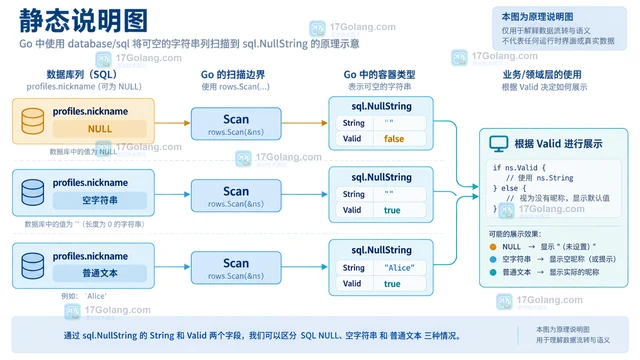
- Golang · Go教程 | 2天前 | go · 数据库 · SQL · database/sql 数据库NULL sql.NullString Go数据库查询
- Go database/sql用sql.NullString保留数据库NULL语义的写法
- 501浏览 收藏
-
- Golang · Go教程 | 2天前 | go · 安全 · 编码 · crypto/rand 随机令牌 RawURLEncoding Go令牌
- Go crypto/rand生成短期令牌并避免编码损失的方案
- 323浏览 收藏
查看更多
课程推荐
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
查看更多
AI推荐
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 185次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 241次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 197次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 178次使用
-

- CMMLU
- 深入了解CMMLU中文评估基准,涵盖67个学科主题,提供数据集下载、Zero-shot/Five-shot评估方法及排行榜,助力优化中文语言模型性能。
- 169次使用
查看更多
相关文章
-
- Java 性能优化上线清单:从定位、改造到灰度发布
- 2026-06-11 860浏览
-
- Spring Boot 压测验证:Gatling、JMeter 与性能回归门禁
- 2026-06-11 843浏览
-
- Java NMT 非堆内存排查:Direct Buffer、线程栈与 Metaspace 分析
- 2026-06-11 826浏览
-
- Spring Boot 容器内存优化:JVM 堆、非堆与 MaxRAMPercentage
- 2026-06-11 809浏览
-
- Tomcat 连接与线程参数调优:maxThreads、acceptCount 与 KeepAlive
- 2026-06-11 792浏览


