
mysql数据同步到mariadb ColumnStore,如何进行全量同步和增量同步?
对于一个数据库开发者来说,牢固扎实的基础是十分重要的,golang学习网就来带大家一点点的掌握基础知识点。今天本篇文章带大家了解《mysql数据同步到mariadb ColumnStore,如何进行全量同步和增量同步?》,主要介绍了MySQL、数据同步,希望对大家的知识积累有所帮助,快点收藏起来吧,否则需要时就找不到了!
MariaDB ColumnStore专为大数据扩展而设计,可处理PB级数据,线性可伸缩性和出色的性能,并能对分析查询进行实时响应。 它利用列式存储,压缩,即时投影以及水平和垂直分区的I / O优势在分析大型数据集时提供了出色的性能。(这是官方的介绍,https://mariadb.com/kb/en/mariadb-columnstore/)
本人自研发了一个mysql -> mariadb columnStore同步工具,同时支持全量同步和增量同步模式,github地址:https://github.com/yutianyong125/mcs_etl
接下来演示一下同步过程
下载该项目
git clone https://github.com/yutianyong125/mcs_etl.git
cd mcs_etl
启动mysql,方便起见,这里使用docker,仅测试,不考虑数据挂载问题,这里我把secure-file-priv配置的目录挂载出来,是为了导入数据的时候用到,另需要指定使用自定义的mysql配置文件
vim /tmp/conf.d/my.cnf

# 保存为以下配置

[mysqld]
log_bin = mysql_bin # 开启binlog日志并指定binlog日志命名前缀
binlog_format=ROW # 指定binlog格式
server_id = 1 # 指定master server_id
secure_file_priv=/tmp/mysql-files # SELECT INTO OUTFILE 语句需要开启这个配置
mkdir /tmp/mysql-files # 先创建好存放导出数据的文件夹

docker run --rm -d --name mysql -v /tmp/conf.d:/etc/mysql/conf.d -v /tmp/mysql-files:/tmp/mysql-files -e MYSQL_ROOT_PASSWORD=123456 -p 3306:3306 mysql:5.7 --character-set-server=utf8mb4 --collation-server=utf8mb4_unicode_ci --secure-file-priv=/tmp/mysql-files
使用存储过程添加测试数据
-- 创建test库
create database test;
use test;

-- 创建user表

CREATE TABLE user(
  id INT NOT NULL AUTO_INCREMENT,
  uname VARCHAR(20) NOT NULL,
  sex VARCHAR(5) NOT NULL,
  score INT NOT NULL,
  copy_id INT NOT NULL,
  PRIMARY KEY (`id`)
) ENGINE=INNODB CHARSET=utf8;

-- 存储过程插入10万条数据

DROP PROCEDURE IF EXISTS add_user;
DELIMITER //
    create PROCEDURE add_user(in num INT)
    BEGIN
        DECLARE rowid INT DEFAULT 0;
        DECLARE firstname CHAR(1);
        DECLARE name1 CHAR(1);
        DECLARE name2 CHAR(1);
        DECLARE sex CHAR(1);
        DECLARE score CHAR(2);
        DECLARE uname CHAR(3);
        WHILE rowid
启动mariadb columnStore
docker run --rm -d --name mcs -eMARIADB_ROOT_PASSWORD=123456 -p 3307:3306 mariadb/columnstore:1.2.3
修改项目配置文件, conf/etl.toml
# 增量ETL配置段
[IncrementEtl]
  StartFile = "" # 开始同步的binlog文件
  StartPosition = 0 # 开始同步的binlog位置
  ServerId = 100 # 同步slave的serverId,只要不与master serverId相同即可

# 全量ETL配置段
[FullEtl]
  # mysql数据导出存放文件夹
  OutFileDir = "/tmp/mysql-files/"

# 全量ETL规则,Schema: 数据库, Tables: table数组
# eg: 导出整个库的表 tables=["*"],导出特定的表 tables=["test1", "test2"]
[[Rule]]
  Schema = "test"
  Tables = ["user"]
[[Rule]]
  Schema = "test1"
  Tables = ["*"]

# mysql 数据库配置
[Source]
  Host = "127.0.0.1"
  Port = 3306
  User = "root"
  Pwd = "123456"

# mariadb columnStore 数据库配置
[Target]
  Host = "127.0.0.1"
  Port = 3307
  User = "root"
  Pwd = "123456"
执行二进制文件,指定全量同步模式
./mcs_etl -model full
成功输出如下,因为是多协程异步执行任务的,所以总耗时可能与etl时长最大的表相差无几
同步`test1`.`t` 耗时 2.025725559s
同步`test`.`user` 耗时 4.358782152s
fullEtl 耗时 4.373473788s
增量方式进行同步步骤如下:
mysql运行 show master status 查看当前binlog日志文件和Position,修改 conf/etl.toml 配置文件中的IncrementEtl配置段
# 增量ETL配置段
[IncrementEtl]
  StartFile = "mysql_bin.000004" # 开始同步的binlog文件
  StartPosition = 154 # 开始同步的binlog位置
  ServerId = 100 # 同步slave的serverId,只要不与master serverId相同即可
执行二进制文件,指定增量同步模式,此时会进入循环监听等待消费状态
./mcs_etl -model increment
接下来在mysql做一些增删改操作
update `test`.`user` set sex = 0 where id = 1;

insert into `test1`.`t` values (100001, 100001, 100001);

delete from `test1`.`t` where id = 100001;
控制台输出日志如下
binlog恢复的语句:
update `test`.`user` set `id` = '1',`uname` = '邹二君',`sex` = '0',`score` = '59',`copy_id` = '1' where `id` = '1' and `uname` = '邹二君' and `sex` = '1' and `score` = '59' and `copy_id` = '1'
==>
兼容处理转换后的语句:
update `test`.`user` set `id` = '1',`uname` = '邹二君',`sex` = '0',`score` = '59',`copy_id` = '1' where `id` = '1' and `uname` = '邹二君' and `sex` = '1' and `score` = '59' and `copy_id` = '1'

执行结果:
执行成功

binlog恢复的语句:
insert into `test1`.`t` (`id`,`a`,`b`) values ('100001','100001','100001')
==>
兼容处理转换后的语句:
insert into `test1`.`t` (`id`,`a`,`b`) values ('100001','100001','100001')

执行结果:
执行成功

binlog恢复的语句:
delete from `test1`.`t` where `id` = '100001' and `a` = '100001' and `b` = '100001'
==>
兼容处理转换后的语句:
delete from `test1`.`t` where `id` = '100001' and `a` = '100001' and `b` = '100001'

执行结果:
执行成功
今天带大家了解了MySQL、数据同步的相关知识,希望对你有所帮助;关于数据库的技术知识我们会一点点深入介绍,欢迎大家关注golang学习网公众号,一起学习编程~
 idea中springboot项目连接数据库报错可能原因
- 上一篇
- idea中springboot项目连接数据库报错可能原因
- 下一篇
- Mysql 增加新数据,若存在则更新的问题
-
- 能干的红牛
- 太给力了,一直没懂这个问题,但其实工作中常常有遇到...不过今天到这,帮助很大,总算是懂了,感谢老哥分享博文!
- 2023-01-29 22:58:47
-
- 粗暴的小松鼠
- 这篇技术文章出现的刚刚好,太全面了,很好,收藏了,关注作者大大了!希望作者大大能多写数据库相关的文章。
- 2023-01-27 17:05:00
-
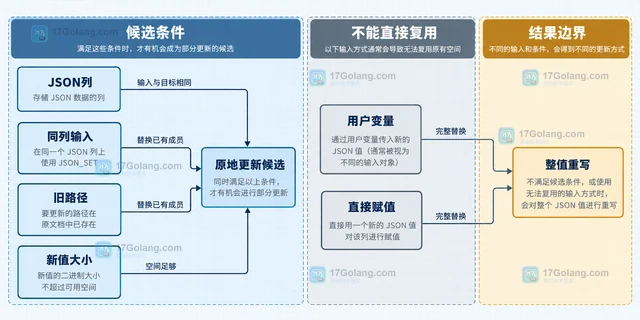
- 数据库 · MySQL | 7小时前 | MySQL · JSON · 性能优化 · mysql 部分更新 JSON_SET JSON_STORAGE_FREE
- MySQL JSON 部分更新什么时候真的生效
- 132浏览 收藏
-
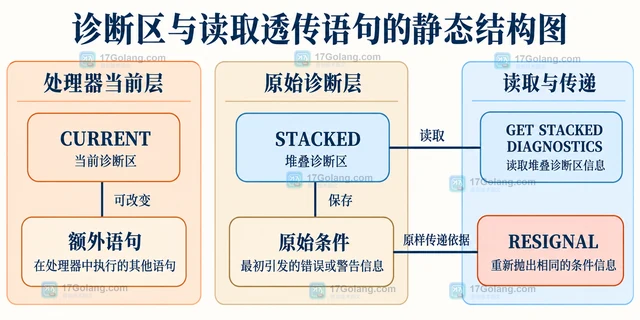
- 数据库 · MySQL | 7小时前 | mysql 存储过程 错误信息 RESIGNAL GET STACKED DIAGNOSTICS
- MySQL RESIGNAL 怎样在存储程序中保留原始错误信息
- 280浏览 收藏
-
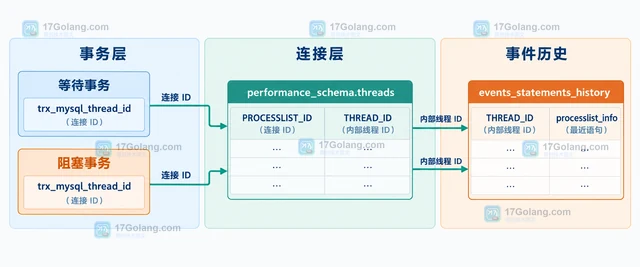
- 数据库 · MySQL | 7小时前 | MySQL · InnoDB · 数据库运维 · mysql Threads 锁等待 data_locks performance_schema data_lock_waits INNODB_TRX 阻塞事务
- MySQL 锁等待超时怎样从 performance_schema 找阻塞者
- 458浏览 收藏
-
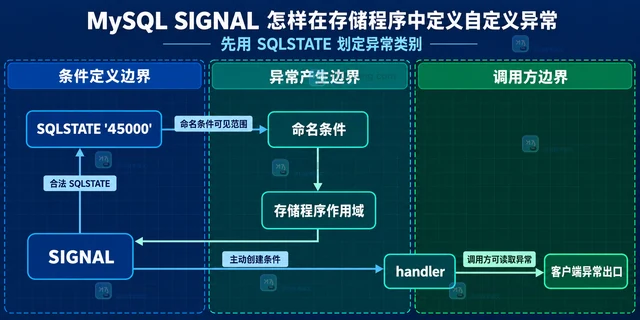
- 数据库 · MySQL | 7小时前 |
- MySQL SIGNAL 怎样在存储程序中定义自定义异常
- 132浏览 收藏
-
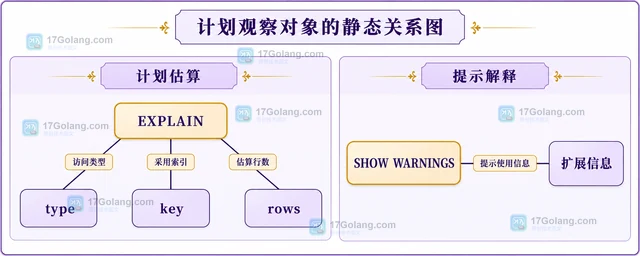
- 数据库 · MySQL | 7小时前 | mysql optimizer hint 连接顺序 JOIN_ORDER JOIN_PREFIX
- MySQL optimizer hint 怎样限定连接顺序
- 403浏览 收藏
-
- 数据库 · MySQL | 7小时前 | MySQL · 事务 · 故障排查 · mysql transaction_read_only INNODB_TRX START TRANSACTION SET TRANSACTION
- MySQL 事务只读模式怎样判断当前连接能否写入
- 102浏览 收藏
-
- 数据库 · MySQL | 7小时前 | mysql visible 不可见索引 SET_VAR optimizer_switch
- MySQL 不可见索引怎样临时恢复可见性
- 124浏览 收藏
-
- 数据库 · MySQL | 7小时前 |
- MySQL JSON_TABLE 怎样展开嵌套数组又保留没有子项的行
- 231浏览 收藏
-
- 数据库 · MySQL | 7小时前 |
- MySQL JSON_VALUE 怎样区分路径不存在和 JSON 空值
- 488浏览 收藏
-
- 数据库 · MySQL | 8小时前 |
- MySQL GROUP BY WITH ROLLUP 识别小计与总计行的判断方法
- 483浏览 收藏
-
- 数据库 · MySQL | 8小时前 |
- MySQL CTE 怎样判断是否应该物化
- 315浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 573次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 616次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 646次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 605次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 422次使用
-
- MySQL 明明加了索引,为什么查询还是很慢?先查这 6 个点
- 2026-06-27 374浏览
-
- golang MySQL实现对数据库表存储获取操作示例
- 2022-12-22 499浏览
-
- golang 基于 mysql 简单实现分布式读写锁
- 2023-01-07 384浏览
-
- 详解如何利用GORM实现MySQL事务
- 2023-01-07 184浏览
-
- Go语言实现操作MySQL的基础知识总结
- 2023-01-23 265浏览


