
30G 上亿数据的超大文件,如何快速导入生产环境?
小伙伴们对数据库编程感兴趣吗?是否正在学习相关知识点?如果是,那么本文《30G 上亿数据的超大文件,如何快速导入生产环境?》,就很适合你,本篇文章讲解的知识点主要包括并发、MySQL、Java、线程池。在之后的文章中也会多多分享相关知识点,希望对大家的知识积累有所帮助!
Hello,大家好,我是楼下小黑哥~
如果给你一个包含一亿行数据的超大文件,让你在一周之内将数据转化导入生产数据库,你会如何操作?
上面的问题其实是小黑哥前段时间接到一个真实的业务需求,将一个老系统历史数据通过线下文件的方式迁移到新的生产系统。
由于老板们已经敲定了新系统上线时间,所以只留给小黑哥一周的时间将历史数据导入生产系统。
由于时间紧,而数据量又超大,所以小黑哥设计的过程想到一下解决办法:
- 拆分文件
- 多线程导入
欢迎关注我的公众号:小黑十一点半,获得日常干货推送。如果您对我的专题内容感兴趣,也可以关注我的博客:studyidea.cn
拆分文件
首先我们可以写个小程序,或者使用拆分命令
-- 将一个大文件拆分成若干个小文件,每个文件 100000 行
split -l 100000 largeFile.txt -d -a 4 smallFile_
这里之所以选择先将大文件拆分,主要考虑到两个原因:
第一如果程序直接读取这个大文件,假设读取一半的时候,程序突然宕机,这样就会直接丢失文件读取的进度,又需要重新开头读取。
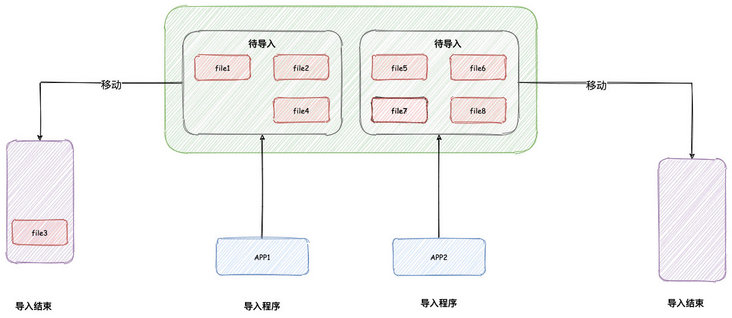
而文件拆分之后,一旦小文件读取结束,我们可以将小文件移动一个指定文件夹。
这样即使应用程序宕机重启,我们重新读取时,只需要读取剩余的文件。
第二,一个文件,只能被一个应用程序读取,这样就限制了导入的速度。
而文件拆分之后,我们可以采用多节点部署的方式,水平扩展。每个节点读取一部分文件,这样就可以成倍的加快导入速度。
多线程导入
当我们拆分完文件,接着我们就需要读取文件内容,进行导入。
之前拆分的时候,设置每个小文件包含 10w 行的数据。由于担心一下子将 10w 数据读取应用中,导致堆内存占用过高,引起频繁的 Full GC,所以下面采用流式读取的方式,一行一行的读取数据。
当然了,如果拆分之后文件很小,或者说应用的堆内存设置很大,我们可以直接将文件加载到应用内存中处理。这样相对来说简单一点。
逐行读取的代码如下:
File file = ...
try (LineIterator iterator = IOUtils.lineIterator(new FileInputStream(file), "UTF-8")) {
    while (iterator.hasNext()) {
        String line=iterator.nextLine();
        convertToDB(line);
    }

}
上面代码使用
Files.lines(Paths.get("文件路径"), Charset.defaultCharset()).forEach(line -> {
    convertToDB(line);
});
其实仔细看下
File file = ...;
ExecutorService executorService = new ThreadPoolExecutor(
        5,
        10,
        60,
        TimeUnit.MINUTES,
              // 文件数量,假设文件包含 10W 行
        new ArrayBlockingQueue(10*10000),
               // guava 提供
        new ThreadFactoryBuilder().setNameFormat("test-%d").build());
try (LineIterator iterator = IOUtils.lineIterator(new FileInputStream(file), "UTF-8")) {
    while (iterator.hasNext()) {
        String line = iterator.nextLine();
        executorService.submit(() -> {
            convertToDB(line);
        });
    }

}
上述代码中,每读取到一行内容,就会直接交给线程池来执行。
我们知道线程池原理如下:
- 如果核心线程数未满,将会直接创建线程执行任务。
- 如果核心线程数已满,将会把任务放入到队列中。
- 如果队列已满,将会再创建线程执行任务。
- 如果最大线程数已满,队列也已满,那么将会执行拒绝策略。
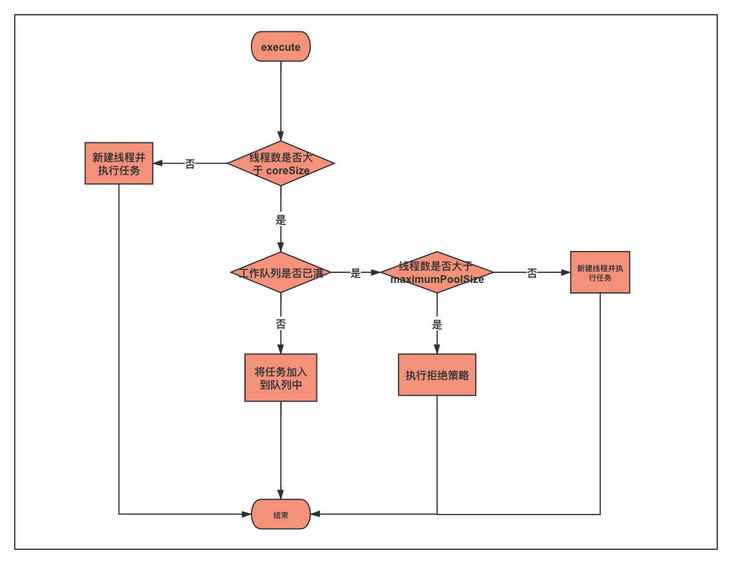
由于我们上述线程池设置的核心线程数为 5,很快就到达了最大核心线程数,后续任务只能被加入队列。
为了后续任务不被线程池拒绝,我们可以采用如下方案:
- 将队列容量设置成很大,包含整个文件所有行数
- 将最大线程数设置成很大,数量大于件所有行数
以上两种方案都存在同样的问题,第一种是相当于将文件所有内容加载到内存,将会占用过多内存。
而第二种创建过多的线程,同样也会占用过多内存。
一旦内存占用过多,GC 无法清理,就可能会引起频繁的 Full GC,甚至导致 OOM,导致程序导入速度过慢。
解决这个问题,我们可以如下两种解决方案:
try (LineIterator iterator = IOUtils.lineIterator(new FileInputStream(file), "UTF-8")) { // 存储每个任务执行的行数 Listlines = Lists.newArrayList(); // 存储异步任务 List tasks = Lists.newArrayList(); while (iterator.hasNext()) { String line = iterator.nextLine(); lines.add(line); // 设置每个线程执行的行数 if (lines.size() == 1000) { // 新建异步任务,注意这里需要创建一个 List tasks.add(new ConvertTask(Lists.newArrayList(lines))); lines.clear(); } if (tasks.size() == 10) { asyncBatchExecuteTask(tasks); } } // 文件读取结束,但是可能还存在未被内容 tasks.add(new ConvertTask(Lists.newArrayList(lines))); // 最后再执行一次 asyncBatchExecuteTask(tasks); } 这段代码中,每个异步任务将会导入 1000 行数据,等积累了 10 个异步任务,然后将会调用
/**
 * 批量执行任务
 *
 * @param tasks
 */
private static void asyncBatchExecuteTask(List tasks) throws InterruptedException {
    CountDownLatch countDownLatch = new CountDownLatch(tasks.size());
    for (ConvertTask task : tasks) {
        task.setCountDownLatch(countDownLatch);
        executorService.submit(task);
    }
    // 主线程等待异步线程 countDownLatch 执行结束
    countDownLatch.await();
    // 清空,重新添加任务
    tasks.clear();
}
/** * 异步任务 * 等数据导入完成之后,一定要调用 countDownLatch.countDown() * 不然,这个主线程将会被阻塞, */ private static class ConvertTask implements Runnable { private CountDownLatch countDownLatch; private Listlines; public ConvertTask(List lines) { this.lines = lines; } public void setCountDownLatch(CountDownLatch countDownLatch) { this.countDownLatch = countDownLatch; } @Override public void run() { try { for (String line : lines) { convertToDB(line); } } finally { countDownLatch.countDown(); } } } RejectedExecutionHandler rejectedExecutionHandler = new RejectedExecutionHandler() { @Override public void rejectedExecution(Runnable r, ThreadPoolExecutor executor) { if (!executor.isShutdown()) { try { executor.getQueue().put(r); } catch (InterruptedException e) { // should not be interrupted } } } };这样一旦线程池满载,主线程将会被阻塞。
使用这种方式之后,我们可以直接使用上面提到的多线程导入的代码。
ExecutorService executorService = new ThreadPoolExecutor(
        5,
        10,
        60,
        TimeUnit.MINUTES,
        new ArrayBlockingQueue(100),
        new ThreadFactoryBuilder().setNameFormat("test-%d").build(),
        (r, executor) -> {
            if (!executor.isShutdown()) {
                try {
                      // 主线程将会被阻塞
                    executor.getQueue().put(r);
                } catch (InterruptedException e) {
                    // should not be interrupted
                }
            }

        });
File file = new File("文件路径");

try (LineIterator iterator = IOUtils.lineIterator(new FileInputStream(file), "UTF-8")) {
    while (iterator.hasNext()) {
        String line = iterator.nextLine();
        executorService.submit(() -> convertToDB(line));
    }
}
小结
一个超大的文件,我们可以采用拆分文件的方式,将其拆分成多份文件,然后部署多个应用程序提高读取速度。
另外读取过程我们还可以使用多线程的方式并发导入,不过我们需要注意线程池满载之后,将会拒绝后续任务。
我们可以通过扩展线程池,自定义拒绝策略,使读取主线程阻塞。
好了,今天文章内容就到这里,不知道各位有没有其他更好的解决办法,欢迎留言讨论。
欢迎关注我的公众号:小黑十一点半,获得日常干货推送。如果您对我的专题内容感兴趣,也可以关注我的博客:studyidea.cn
以上就是本文的全部内容了,是否有顺利帮助你解决问题?若是能给你带来学习上的帮助,请大家多多支持golang学习网!更多关于数据库的相关知识,也可关注golang学习网公众号。
 Django models 使用mysql的limit和offset功能
- 上一篇
- Django models 使用mysql的limit和offset功能
- 下一篇
- idea中springboot项目连接数据库报错可能原因
-
- 粗暴的小松鼠
- 这篇文章内容出现的刚刚好,细节满满,很棒,收藏了,关注作者大大了!希望作者大大能多写数据库相关的文章。
- 2023-03-11 02:59:38
-
- 冷傲的心情
- 太详细了,mark,感谢楼主的这篇博文,我会继续支持!
- 2023-03-08 20:50:22
-
- 要减肥的唇膏
- 很有用,一直没懂这个问题,但其实工作中常常有遇到...不过今天到这,看完之后很有帮助,总算是懂了,感谢楼主分享技术贴!
- 2023-02-28 17:49:26
-
- 数据库 · MySQL | 8小时前 | MySQL · JSON · 性能优化 · mysql 部分更新 JSON_SET JSON_STORAGE_FREE
- MySQL JSON 部分更新什么时候真的生效
- 132浏览 收藏
-
- 数据库 · MySQL | 8小时前 | mysql 存储过程 错误信息 RESIGNAL GET STACKED DIAGNOSTICS
- MySQL RESIGNAL 怎样在存储程序中保留原始错误信息
- 280浏览 收藏
-
- 数据库 · MySQL | 8小时前 | MySQL · InnoDB · 数据库运维 · mysql Threads 锁等待 data_locks performance_schema data_lock_waits INNODB_TRX 阻塞事务
- MySQL 锁等待超时怎样从 performance_schema 找阻塞者
- 458浏览 收藏
-
- 数据库 · MySQL | 8小时前 |
- MySQL SIGNAL 怎样在存储程序中定义自定义异常
- 132浏览 收藏
-
- 数据库 · MySQL | 8小时前 | mysql optimizer hint 连接顺序 JOIN_ORDER JOIN_PREFIX
- MySQL optimizer hint 怎样限定连接顺序
- 403浏览 收藏
-
- 数据库 · MySQL | 8小时前 | MySQL · 事务 · 故障排查 · mysql transaction_read_only INNODB_TRX START TRANSACTION SET TRANSACTION
- MySQL 事务只读模式怎样判断当前连接能否写入
- 102浏览 收藏
-
- 数据库 · MySQL | 9小时前 | mysql visible 不可见索引 SET_VAR optimizer_switch
- MySQL 不可见索引怎样临时恢复可见性
- 124浏览 收藏
-
- 数据库 · MySQL | 9小时前 |
- MySQL JSON_TABLE 怎样展开嵌套数组又保留没有子项的行
- 231浏览 收藏
-
- 数据库 · MySQL | 9小时前 |
- MySQL JSON_VALUE 怎样区分路径不存在和 JSON 空值
- 488浏览 收藏
-
- 数据库 · MySQL | 9小时前 |
- MySQL GROUP BY WITH ROLLUP 识别小计与总计行的判断方法
- 483浏览 收藏
-
- 数据库 · MySQL | 10小时前 |
- MySQL CTE 怎样判断是否应该物化
- 315浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 573次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 616次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 647次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 606次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 422次使用
-
- MySQL 明明加了索引,为什么查询还是很慢?先查这 6 个点
- 2026-06-27 374浏览
-
- Go map 并发写 panic 怎么办:从共享 map 到可控写入路径
- 2026-06-30 123浏览
-
- golang MySQL实现对数据库表存储获取操作示例
- 2022-12-22 499浏览
-
- golang 基于 mysql 简单实现分布式读写锁
- 2023-01-07 384浏览
-
- 详解如何利用GORM实现MySQL事务
- 2023-01-07 184浏览


