
使用canal+Kafka进行数据库同步实践
在数据库实战开发的过程中,我们经常会遇到一些这样那样的问题,然后要卡好半天,等问题解决了才发现原来一些细节知识点还是没有掌握好。今天golang学习网就整理分享《使用canal+Kafka进行数据库同步实践》,聊聊MySQL、微服务、数据库、kubernetes,希望可以帮助到正在努力赚钱的你。
在微服务拆分的架构中,各服务拥有自己的数据库,所以常常会遇到服务之间数据通信的问题。比如,B服务数据库的数据来源于A服务的数据库;A服务的数据有变更操作时,需要同步到B服务中。
第一种解决方案:
在代码逻辑中,有相关A服务数据写操作时,以调用接口的方式,调用B服务接口,B服务再将数据写到新的数据库中。这种方式看似简单,但其实“坑”很多。在A服务代码逻辑中会增加大量这种调用接口同步的代码,增加了项目代码的复杂度,以后会越来越难维护。并且,接口调用的方式并不是一个稳定的方式,没有重试机制,没有同步位置记录,接口调用失败了怎么处理,突然的大量接口调用会产生的问题等,这些都要考虑并且在业务中处理。这里会有不少工作量。想到这里,就将这个方案排除了。
第二种解决方案:
通过数据库的binlog进行同步。这种解决方案,与A服务是独立的,不会和A服务有代码上的耦合。可以直接TCP连接进行传输数据,优于接口调用的方式。 这是一套成熟的生产解决方案,也有不少binlog同步的中间件工具,所以我们关注的就是哪个工具能够更好的构建稳定、性能满足且易于高可用部署的方案。
经过调研,我们选择了
func Handler(entry protocol.Entry)  {
    var keys []string
    rowChange := &protocol.RowChange{}
    proto.Unmarshal(entry.GetStoreValue(), rowChange)
    if rowChange != nil {
        eventType := rowChange.GetEventType()
        for _, rowData := range rowChange.GetRowDatas() { // 遍历每一行数据             if eventType == protocol.EventType_DELETE || eventType == protocol.EventType_UPDATE {
                 columns := rowData.GetBeforeColumns() // 得到更改前的所有字段属性             } else if eventType == protocol.EventType_INSERT {
                 columns := rowData.GetAfterColumns() // 得到更后前的所有字段属性             }
            ......
        }
    }
}
遇到的问题
为了高可用和更高的性能,我们会创建多个
# ...
# 可选项: tcp(默认), kafka, RocketMQ
canal.serverMode = kafka
# ...
# kafka/rocketmq 集群配置: 192.168.1.117:9092,192.168.1.118:9092,192.168.1.119:9092
canal.mq.servers = 127.0.0.1:9002
canal.mq.retries = 0
# flagMessage模式下可以调大该值, 但不要超过MQ消息体大小上限
canal.mq.batchSize = 16384
canal.mq.maxRequestSize = 1048576
# flatMessage模式下请将该值改大, 建议50-200
canal.mq.lingerMs = 1
canal.mq.bufferMemory = 33554432
# Canal的batch size, 默认50K, 由于kafka最大消息体限制请勿超过1M(900K以下)
canal.mq.canalBatchSize = 50
# Canal get数据的超时时间, 单位: 毫秒, 空为不限超时
canal.mq.canalGetTimeout = 100
# 是否为flat json格式对象
canal.mq.flatMessage = false
canal.mq.compressionType = none
canal.mq.acks = all
# kafka消息投递是否使用事务
canal.mq.transaction = false

# mq config
canal.mq.topic=default
# dynamic topic route by schema or table regex
#canal.mq.dynamicTopic=mytest1.user,mytest2..*,.*..*
canal.mq.dynamicTopic=mydatabase.mytable
canal.mq.partition=0
# hash partition config
canal.mq.partitionsNum=3
canal.mq.partitionHash=mydatabase.mytable
具体见:https://github.com/alibaba/canal/wiki/Canal-Kafka-RocketMQ-QuickStart
解决顺序消费问题
看到下面这一行配置
canal.mq.partitionHash=mydatabase.mytable
我们配置了kafka的partitionHash,并且我们一个Topic就是一个表。这样的效果就是,一个表的数据只会推到一个固定的partition中,然后再推给consumer进行消费处理,同步到新的数据库。通过这种方式,解决了之前碰到的binlog日志顺序处理的问题。这样即使我们部署了多个kafka consumer端,构成一个集群,这样consumer从一个partition消费消息,就是消费处理同一个表的数据。这样对于一个表来说,牺牲掉了并行处理,不过个人觉得,凭借kafka的性能强大的处理架构,我们的业务在kafka这个节点产生瓶颈并不容易。并且我们的业务目的不是实时一致性,在一定延迟下,两个数据库保证最终一致性。
下图是最终的同步架构,我们在每一个服务节点都实现了集群化。全都跑在UCloud的UK8s服务上,保证了服务节点的高可用性。
canal也是集群换,但是某一时刻只会有一台canal在处理binlog,其他都是冗余服务。当这台canal服务挂了,其中一台冗余服务就会切换到工作状态。同样的,也是因为要保证binlog的顺序读取,所以只能有一台canal在工作。

并且,我们还用这套架构进行缓存失效的同步。我们使用的缓存模式是:
Cache-Aside。同样的,如果在代码中数据更改的地方进行缓存失效操作,会将代码变得复杂。所以,在上述架构的基础上,将复杂的触发缓存失效的逻辑放到
kafka-client端统一处理,达到一定解耦的目的。
目前这套同步架构正常运行中,后续有遇到问题再继续更新。
更多内容,欢迎点击下方作者主页进行交流~
本文作者:UCloud应用研发工程师 Cary
今天关于《使用canal+Kafka进行数据库同步实践》的内容介绍就到此结束,如果有什么疑问或者建议,可以在golang学习网公众号下多多回复交流;文中若有不正之处,也希望回复留言以告知!
 【科创人】瑞云创始人汪忠田:售后服务SaaS市场拓荒者
- 上一篇
- 【科创人】瑞云创始人汪忠田:售后服务SaaS市场拓荒者

- 下一篇
- Mysql ERROR 1449 (HY000)
-
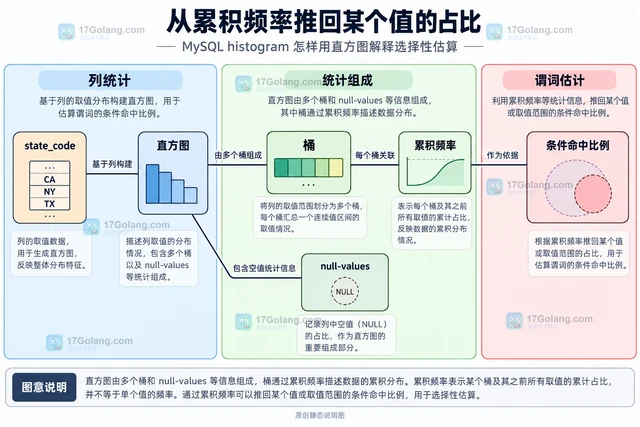
- 数据库 · MySQL | 9小时前 |
- MySQL histogram 怎样用直方图解释选择性估算
- 122浏览 收藏
-
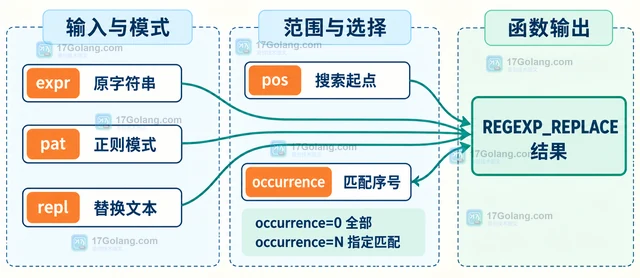
- 数据库 · MySQL | 9小时前 | MySQL · 正则表达式 · mysql regexp_replace 正则替换 pos occurrence match_type
- MySQL REGEXP_REPLACE 怎样只替换指定次数的文本
- 426浏览 收藏
-
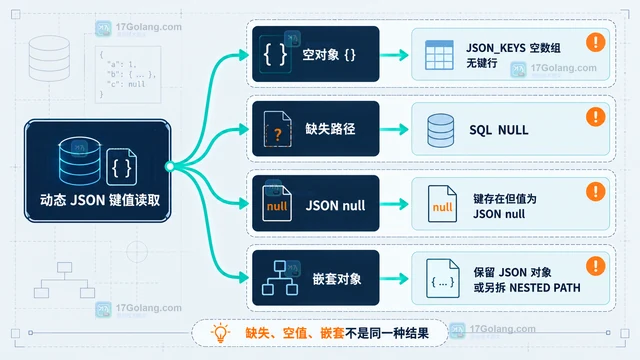
- 数据库 · MySQL | 9小时前 |
- MySQL JSON_TABLE 结合 JSON_KEYS 读取动态对象键名
- 368浏览 收藏
-
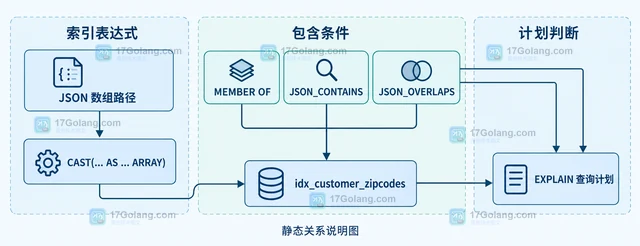
- 数据库 · MySQL | 10小时前 |
- MySQL multi-valued index 怎样为 JSON 数组建立多值索引
- 139浏览 收藏
-
- 数据库 · MySQL | 10小时前 |
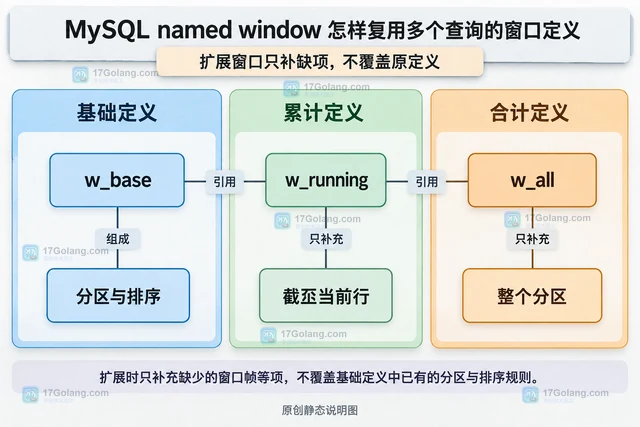
- MySQL named window 怎样复用多个查询的窗口定义
- 226浏览 收藏
-
- 数据库 · MySQL | 10小时前 | MySQL · JSON · 数据库运维 · mysql JSON_MERGE_PATCH JSON null JSON_REMOVE JSON合并
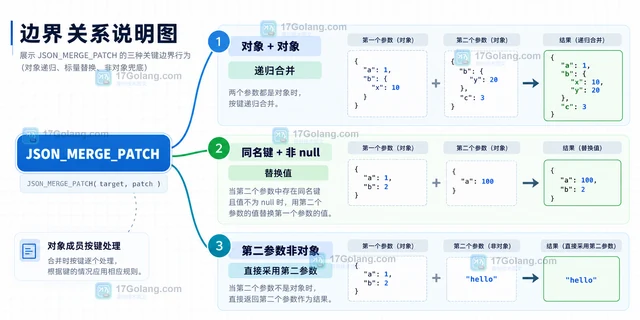
- MySQL JSON_MERGE_PATCH 怎样让 JSON null 删除对象成员
- 287浏览 收藏
-
- 数据库 · MySQL | 10小时前 | MySQL · 窗口函数 ROW_NUMBER PARTITION BY 每组最新记录 MySQL window function
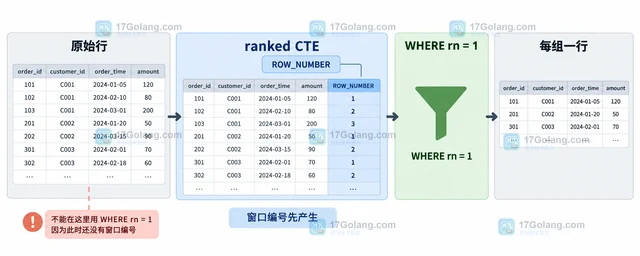
- MySQL window function 怎样用 ROW_NUMBER 取每组最新记录
- 123浏览 收藏
-
- 数据库 · MySQL | 10小时前 |
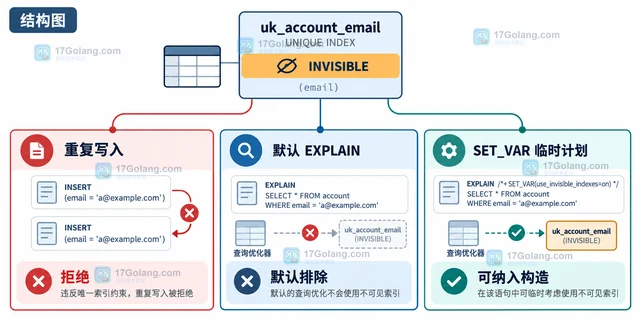
- MySQL invisible index 唯一索引设为不可见后约束还生效吗
- 335浏览 收藏
-
- 数据库 · MySQL | 10小时前 |
- MySQL invisible index 怎样临时让优化器使用不可见索引
- 345浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 675次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 695次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 737次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 705次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 542次使用
-
- MySQL 明明加了索引,为什么查询还是很慢?先查这 6 个点
- 2026-06-27 374浏览
-
- 接口返回的数据和数据库不一致怎么办?按数据生命周期排查
- 2026-06-27 398浏览
-
- golang MySQL实现对数据库表存储获取操作示例
- 2022-12-22 499浏览
-
- Go微服务开发框架DMicro设计思路详解
- 2023-01-01 354浏览
-
- golang 基于 mysql 简单实现分布式读写锁
- 2023-01-07 384浏览


