
PyTorch 中的斯坦福汽车
来源:dev.to
2024-12-23 11:36:41
0浏览
收藏
本篇文章主要是结合我之前面试的各种经历和实战开发中遇到的问题解决经验整理的,希望这篇《PyTorch 中的斯坦福汽车》对你有很大帮助!欢迎收藏,分享给更多的需要的朋友学习~
请我喝杯咖啡☕
*我的帖子解释了斯坦福汽车。
stanfordcars()可以使用stanford cars数据集,如下所示:
*备忘录:
- 第一个参数是 root(必需类型:str 或 pathlib.path)。 *绝对或相对路径都是可能的。
- 第二个参数是 split(可选-默认:"train"-类型:str)。 *可以设置“train”(8,144张图片)或“test”(8,041张图片)。
- 第三个参数是transform(optional-default:none-type:callable)。
- 第四个参数是 target_transform(optional-default:none-type:callable)。
- 第五个参数是 download(optional-default:false-type:bool):
*备注:
- 保留为 false,因为如果为 true,则会发生错误,因为原始 url 已损坏。
- 因此,您需要从这里手动下载并解压 archive.zip,从这里解压 archive.zip 以及 car_devkit.tgz 到 data/stanford_cars/ ,如下所示:
*备注:
- cars_test_annos_withlabels (1).mat 需要重命名为 cars_test_annos_withlabels.mat。
- cars_annos.mat 和 cars_annos (2).mat 不需要,并且还有一些重复的文件。
- 您还可以查看说明。
data
 └-stanford_cars
    |-cars_test_annos_withlabels.mat
    |-cars_test
    |  └-*.jpg
    |-cars_train
    |  └-*.jpg
    └-devkit
       |-cars_meta.mat
       |-cars_test_annos.mat
       |-cars_train_annos.mat
       |-eval_train.m
       |-readme.txt
       └-train_perfect_preds.txt
from torchvision.datasets import StanfordCars

train_data = StanfordCars(
    root="data"
)

train_data = StanfordCars(
    root="data",
    split="train",
    transform=None,
    target_transform=None,
    download=False
)

test_data = StanfordCars(
    root="data",
    split="test"
)

len(train_data), len(test_data)
# (8144, 8041)

train_data
# Dataset StanfordCars
#     Number of datapoints: 8144
#     Root location: data

train_data.root
# 'data'

train_data._split
# 'train'

print(train_data.transform)
# None

print(train_data.target_transform)
# None

train_data.download
#

len(train_data.classes), train_data.classes
# (196,
#  ['AM General Hummer SUV 2000', 'Acura RL Sedan 2012', 'Acura TL Sedan 2012',
#   'Acura TL Type-S 2008', ..., 'Volvo 240 Sedan 1993',
#   'Volvo XC90 SUV 2007', 'smart fortwo Convertible 2012'])

train_data[0]
# (, 13)

train_data[1]
# (, 2)

train_data[2]
# (, 90)

train_data[3]
# (, 133)

train_data[4]
# (, 105)

import matplotlib.pyplot as plt

def show_images(data, main_title=None):
    plt.figure(figsize=(12, 5))
    plt.suptitle(t=main_title, y=1.0, fontsize=14)
    for i, (im, lab) in zip(range(1, 11), data):
        plt.subplot(2, 5, i)
        plt.imshow(X=im)
        plt.title(label=lab)
    plt.tight_layout()
    plt.show()

show_images(data=train_data, main_title="train_data")
show_images(data=test_data, main_title="test_data")

show_images(data=train_data, ims=train_ims, main_title="train_data")
show_images(data=train_data, ims=val_ims, main_title="val_data")
show_images(data=test_data, ims=test_ims, main_title="test_data")


以上就是《PyTorch 中的斯坦福汽车》的详细内容,更多关于的资料请关注golang学习网公众号!
版本声明
本文转载于:dev.to 如有侵犯,请联系study_golang@163.com删除
 深入解析电脑的构成:硬件与软件的完美结合
- 上一篇
- 深入解析电脑的构成:硬件与软件的完美结合

- 下一篇
- 如何利用PHP从MySQL数据库获取数据并以JSON格式展示在网页中?
查看更多
最新文章
-
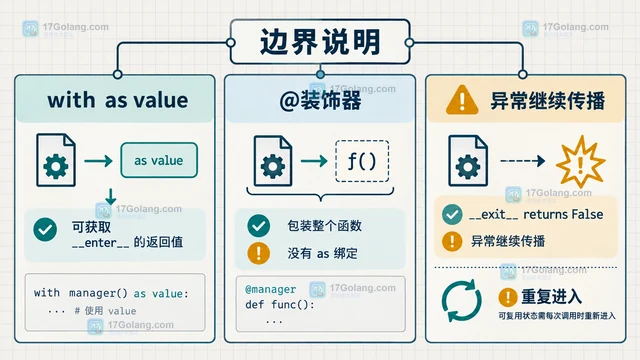
- 文章 · python教程 | 1小时前 | python · Python 异常传播 函数装饰器 contextlib.ContextDecorator with
- Python ContextDecorator 同时支持 with 与函数装饰器的实现边界
- 242浏览 收藏
-
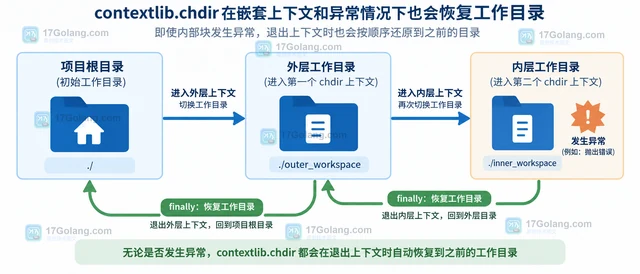
- 文章 · python教程 | 1小时前 | 文件处理 · python · 异常排查 · Python 工作目录 异常恢复 contextlib.chdir
- Python contextlib.chdir 临时切换目录后如何保证异常恢复
- 158浏览 收藏
-
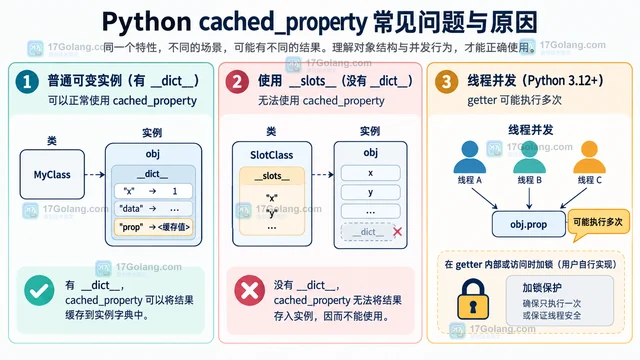
- 文章 · python教程 | 1小时前 | 缓存 · python · Python 缓存失效 实例属性 __dict__ functools.cached_property
- Python functools.cached_property 删除属性后如何强制刷新缓存
- 463浏览 收藏
-
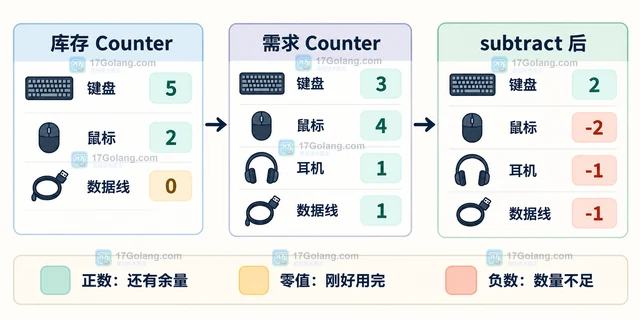
- 文章 · python教程 | 1小时前 | 标准库 · python · 数据处理 · 问题排查 · collections.Counter 库存扣减 Python Counter.subtract 缺失项目 负计数
- Python Counter.subtract 后怎么判断真正缺失的项目
- 410浏览 收藏
-
- 文章 · python教程 | 1小时前 | python ·
- Python defaultdict 访问缺省键为什么会改变字典内容
- 482浏览 收藏
-
- 文章 · python教程 | 1小时前 |
- Python itertools.pairwise 怎么在相邻记录比较中保留首尾信息
- 172浏览 收藏
-
- 文章 · python教程 | 2天前 |
- Python logging Formatter 统一结构化字段输出
- 185浏览 收藏
查看更多
课程推荐
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
查看更多
AI推荐
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 455次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 521次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 536次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 483次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 304次使用
查看更多
相关文章
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览
-
- TensorFlow模型部署为API的TF Serving方法
- 2026-05-26 501浏览
-
- Python字符串编码转换:encode与decode详解
- 2026-05-16 501浏览
-
- TensorFlow裁剪无用算子方法详解
- 2026-05-15 501浏览


