
Mysql到TiDB迁移,双写数据库兜底方案
亲爱的编程学习爱好者,如果你点开了这篇文章,说明你对《Mysql到TiDB迁移,双写数据库兜底方案》很感兴趣。本篇文章就来给大家详细解析一下,主要介绍一下MySQL、数据库、Django、tidb、兼容,希望所有认真读完的童鞋们,都有实质性的提高。
作者:京东零售 石磊
TiDB 作为开源 NewSQL 数据库的典型代表之一,同样支持 SQL,支持事务 ACID 特性。在通讯协议上,TiDB 选择与 MySQL 完全兼容,并尽可能兼容 MySQL 的语法。因此,基于 MySQL 数据库开发的系统,大多数可以平滑迁移至 TiDB,而几乎不用修改代码。对用户来说,迁移成本极低,过渡自然。
然而,仍有一些 MySQL 的特性和行为,TiDB 目前暂时不支持或表现与 MySQL 有差异。除此之外,TiDB 提供了一些扩展语法和功能,为用户提供更多的便利。
TiDB 仍处在快速发展的道路上,对 MySQL 功能和行为的支持方面,正按 路线图 的规划在前行。
兼容策略
先从总体上概括 TiDB 和 MySQL 兼容策略,如下表:
| 通讯协议 | SQL语法 | 功能和行为 |
|---|---|---|
| 完全兼容 | 兼容绝大多数 | 兼容大多数 |
截至 4.0 版本,TiDB 与 MySQL 的区别总结如下表:
| | MySQL | TiDB |
|---|---|---|
| 隔离级别 | 支持读未提交、读已提交、可重复读、串行化,默认为可重复读 | 乐观事务支持快照隔离,悲观事务支持快照隔离和读已提交 |
| 锁机制 | 悲观锁 | 乐观锁、悲观锁 |
| 存储过程 | 支持 | 不支持 |
| 触发器 | 支持 | 不支持 |
| 事件 | 支持 | 不支持 |
| 自定义函数 | 支持 | 不支持 |
| 窗口函数 | 支持 | 部分支持 |
| JSON | 支持 | 不支持部分 MySQL 8.0 新增的函数 |
| 外键约束 | 支持 | 忽略外键约束 |
| 字符集 | | 只支持 ascii、latin1、binary、utf8、utf8mb4 |
| 增加/删除主键 | 支持 | 通过 alter-primary-key 配置开关提供 |
| CREATE TABLE tblName AS SELECT stmt | 支持 | 不支持 |
| CREATE TEMPORARY TABLE | 支持 | TiDB 忽略 TEMPORARY 关键字,按照普通表创建 |
| DML affected rows | 支持 | 不支持 |
| AutoRandom 列属性 | 不支持 | 支持 |
| Sequence 序列生成器 | 不支持 | 支持 |
三种方案比较
双写方案:同时往mysql和tidb写入数据,两个数据库数据完全保持同步
•优点:此方案最安全,作为兜底方案不需担心数据库回滚问题,因为数据完全一致,可以无缝回滚到mysql
•缺点:新方案,调研方案实现,成本较高
读写分离:数据写入mysql,从tidb读,具体方案是切换到线上以后,保持读写分离一周时间左右,这一周时间用来确定tidb数据库没有问题,再把写操作也切换到tidb
•优点: 切换过程,mysql和tidb数据保持同步,满足数据回滚到mysql方案
•缺点:mysql和tidb数据库同步存在延时,对部分写入数据要求实时查询的会导致查询失败,同时一旦整体切换到tidb,无法回切到mysql
直接切换:直接一步切换到tidb
•优点:切换过程最简单,成本最低
•缺点:此方案没有兜底方案,切换到tidb,无法再回切到mysql或者同步数据回mysql风险较大,无法保证数据是否可用
Django双写mysql与tidb策略
settings.py中新增配置
# Dev Database settings
DATABASES = {
    'default': {
        'ENGINE': 'django.db.backends.mysql',
        'NAME': 'name',
        'USER': 'root',
        'PASSWORD': '123456',
        'HOST': 'db',
    },
    'replica': {
        'ENGINE': 'django.db.backends.mysql',
        'NAME': 'name',
        'USER': 'root',
        'PASSWORD': '123456',
        'HOST': 'db',
    },
    'bak': {
        'ENGINE': 'django.db.backends.mysql',
        'NAME': 'name',
        'USER': 'root',
        'PASSWORD': '123456',
        'HOST': 'db',
    },
}
# 多重写入数据库配置
MULTI_WRITE_DB = "bak"
双写中间件 basemodel.py
import copy
import logging
import traceback
from django.db import models, transaction, router
from django.db.models.deletion import Collector
from django.db.models import sql
from django.db.models.sql.constants import CURSOR
from jcdp.settings import MULTI_WRITE_DB, DATABASES

multi_write_db = MULTI_WRITE_DB


# 重写QuerySet
class BaseQuerySet(models.QuerySet):

    def create(self, **kwargs):
        return super().create(**kwargs)

    def update(self, **kwargs):
        try:
            rows = super().update(**kwargs)
            if multi_write_db in DATABASES:
                self._for_write = True
                query = self.query.chain(sql.UpdateQuery)
                query.add_update_values(kwargs)
                with transaction.mark_for_rollback_on_error(using=multi_write_db):
                    query.get_compiler(multi_write_db).execute_sql(CURSOR)
        except Exception:
            logging.error(traceback.format_exc())
            raise
        return rows

    def delete(self):
        try:
            deleted, _rows_count = super().delete()
            if multi_write_db in DATABASES:
                del_query = self._chain()
                del_query._for_write = True
                del_query.query.select_for_update = False
                del_query.query.select_related = False
                collector = Collector(using=multi_write_db)
                collector.collect(del_query)
                collector.delete()
        except Exception:
            logging.error(traceback.format_exc())
            raise
        return deleted, _rows_count

    def raw(self, raw_query, params=None, translations=None, using=None):
        try:
            qs = super().raw(raw_query, params=params, translations=translations, using=using)
            if multi_write_db in DATABASES:
                super().raw(raw_query, params=params, translations=translations, using=multi_write_db)
        except Exception:
            logging.error(traceback.format_exc())
            raise
        return qs

    def bulk_create(self, objs, batch_size=None, ignore_conflicts=False):
        try:
            for obj in objs:
                obj.save()
        except Exception:
            logging.error(traceback.format_exc())
            raise
        # objs = super().bulk_create(objs, batch_size=batch_size, ignore_conflicts=ignore_conflicts)
        # if multi_write_db in DATABASES:
        #     self._db = multi_write_db
        #     super().bulk_create(objs, batch_size=batch_size, ignore_conflicts=ignore_conflicts)
        return objs

    def bulk_update(self, objs, fields, batch_size=None):
        try:
            super().bulk_update(objs, fields, batch_size=batch_size)
            if multi_write_db in DATABASES:
                self._db = multi_write_db
                super().bulk_update(objs, fields, batch_size=batch_size)
        except Exception:
            logging.error(traceback.format_exc())
            raise


class BaseManager(models.Manager):
    _queryset_class = BaseQuerySet


class BaseModel(models.Model):
    objects = BaseManager()

    class Meta:
        abstract = True

    def delete(
            self, using=None, *args, **kwargs
    ):
        try:
            instance = copy.deepcopy(self)
            super().delete(using=using, *args, **kwargs)
            if multi_write_db in DATABASES:
                super(BaseModel, instance).delete(using=multi_write_db, *args, **kwargs)
        except Exception:
            logging.error(traceback.format_exc())
            raise

    def save_base(self, raw=False, force_insert=False,
                  force_update=False, using=None, update_fields=None):
        try:
            using = using or router.db_for_write(self.__class__, instance=self)
            assert not (force_insert and (force_update or update_fields))
            assert update_fields is None or update_fields
            cls = self.__class__
            # Skip proxies, but keep the origin as the proxy model.
            if cls._meta.proxy:
                cls = cls._meta.concrete_model
            meta = cls._meta
            # A transaction isn't needed if one query is issued.
            if meta.parents:
                context_manager = transaction.atomic(using=using, savepoint=False)
            else:
                context_manager = transaction.mark_for_rollback_on_error(using=using)
            with context_manager:
                parent_inserted = False
                if not raw:
                    parent_inserted = self._save_parents(cls, using, update_fields)
                self._save_table(
                    raw, cls, force_insert or parent_inserted,
                    force_update, using, update_fields,
                )
            if multi_write_db in DATABASES:
                super().save_base(raw=raw,
                                  force_insert=raw,
                                  force_update=force_update,
                                  using=multi_write_db,
                                  update_fields=update_fields)
            # Store the database on which the object was saved
            self._state.db = using
            # Once saved, this is no longer a to-be-added instance.
            self._state.adding = False
        except Exception:
            logging.error(traceback.format_exc())
            raise
上述配置完成以后,在每个应用的models.py中引用新的BaseModel类作为模型基类即可实现双写目的
class DirectoryStructure(BaseModel):
    """
    目录结构
    """
    view = models.CharField(max_length=128, db_index=True)  # 视图名称 eg:部门视图 项目视图
    sub_view = models.CharField(max_length=128, unique=True, db_index=True)  # 子视图名称
    sub_view_num = models.IntegerField()  # 子视图顺序号
注:目前该方法尚不支持多对多模型的双写情景,如有业务需求,还需重写ManyToManyField类,方法参考猴子补丁方式
迁移数据库过程踩坑记录
TIDB配置项差异:确认数据库配置:ONLY_FULL_GROUP_BY 禁用 (mysql默认禁用)
TIDB不支持事务savepoint,代码中需要显式关闭savepoint=False
TIDB由于是分布式数据库,对于自增主键字段的自增策略与mysq有差异,若业务代码会与主键id关联,需要注意。
以上就是《Mysql到TiDB迁移,双写数据库兜底方案》的详细内容,更多关于mysql的资料请关注golang学习网公众号!
 进来偷学一招,数据归档二三事儿
- 上一篇
- 进来偷学一招,数据归档二三事儿
- 下一篇
- 入驻紫光展锐坦克邦,向“芯”出发,共建共赢
-
- 数据库 · MySQL | 4小时前 |
- MySQL 锁等待超时怎样定位阻塞事务
- 325浏览 收藏
-
- 数据库 · MySQL | 4小时前 | MySQL · mysql 时区 STR_TO_DATE 日期时间 CONVERT_TZ
- MySQL STR_TO_DATE 怎样处理带时区的日期字符串
- 117浏览 收藏
-
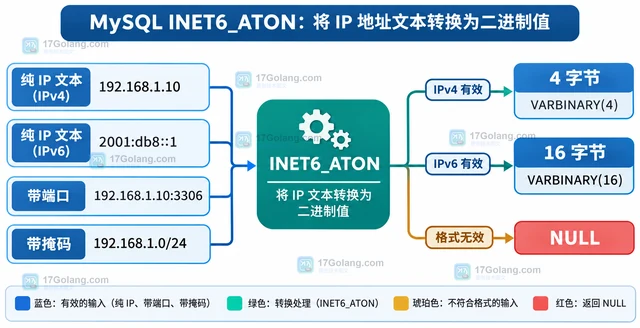
- 数据库 · MySQL | 4小时前 | MySQL · 数据校验 · mysql IPv6 INET6_ATON INET6_NTOA VARBINARY
- MySQL INET6_ATON 怎样把 IPv6 文本转成二进制
- 207浏览 收藏
-
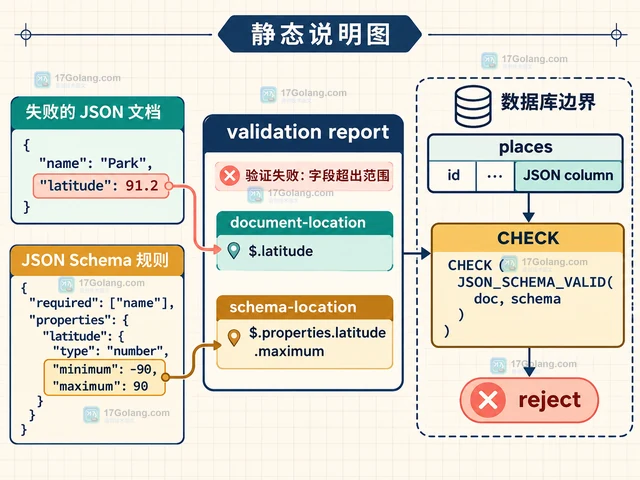
- 数据库 · MySQL | 4小时前 |
- MySQL JSON_SCHEMA_VALID 怎样校验 JSON 文档
- 331浏览 收藏
-
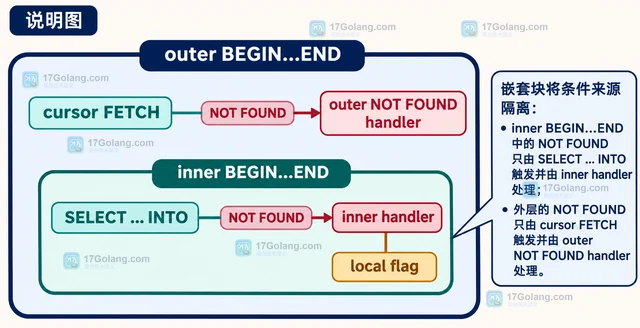
- 数据库 · MySQL | 4小时前 |
- MySQL DECLARE HANDLER 怎样只处理 NOT FOUND 条件
- 160浏览 收藏
-
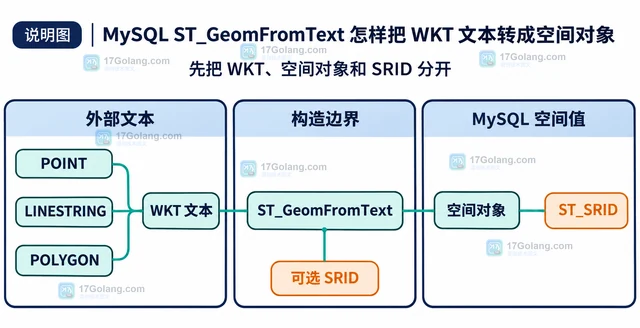
- 数据库 · MySQL | 5小时前 |
- MySQL ST_GeomFromText 怎样把 WKT 文本转成空间对象
- 339浏览 收藏
-
- 数据库 · MySQL | 5小时前 |
- MySQL WITH ROLLUP 怎样生成小计和总计
- 107浏览 收藏
-
- 数据库 · MySQL | 5小时前 |
- MySQL REGEXP_LIKE 怎样判断字符串是否匹配正则
- 108浏览 收藏
-
- 数据库 · MySQL | 5小时前 |
- MySQL 派生表为什么阻止索引下推
- 412浏览 收藏
-
- 数据库 · MySQL | 5小时前 |
- MySQL optimizer hint 怎样临时禁止索引合并
- 325浏览 收藏
-
- 数据库 · MySQL | 5小时前 |
- MySQL performance_schema.setup_consumers 怎样开启长语句历史
- 332浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 856次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 860次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 938次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 914次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 746次使用
-
- MySQL 明明加了索引,为什么查询还是很慢?先查这 6 个点
- 2026-06-27 374浏览
-
- 接口返回的数据和数据库不一致怎么办?按数据生命周期排查
- 2026-06-27 398浏览
-
- golang MySQL实现对数据库表存储获取操作示例
- 2022-12-22 499浏览
-
- golang 基于 mysql 简单实现分布式读写锁
- 2023-01-07 384浏览
-
- 详解如何利用GORM实现MySQL事务
- 2023-01-07 184浏览


