
使用 Python 进行词嵌入:docc
你在学习文章相关的知识吗?本文《使用 Python 进行词嵌入:docc》,主要介绍的内容就涉及到,如果你想提升自己的开发能力,就不要错过这篇文章,大家要知道编程理论基础和实战操作都是不可或缺的哦!
使用 python(和 gensim)实现 doc2vec
注意:此代码是用 python 3.6.1 (+gensim 2.3.0) 编写的
doc2vec与gensim的python实现及应用
import re
import numpy as np

from gensim.models import doc2vec
from gensim.models.doc2vec import taggeddocument
from nltk.corpus import gutenberg
from multiprocessing import pool
from scipy import spatial
- 导入训练数据集
- 从nltk库导入莎士比亚的哈姆雷特语料库
sentences = list(gutenberg.sents('shakespeare-hamlet.txt'))   # import the corpus and convert into a list

print('type of corpus: ', type(sentences))
print('length of corpus: ', len(sentences))
语料库类型:类“list”
语料库长度:3106
print(sentences[0])    # title, author, and year
print(sentences[1])
print(sentences[10])
['[', 'the', '悲剧', 'of', '哈姆雷特', 'by', '威廉', '莎士比亚', '1599', ']']
['actus', 'primus', '.']
['弗兰', '.']
预处理数据
- 使用re模块预处理数据
- 将所有字母转换为小写
- 删除标点符号、数字等
- 对于doc2vec模型,输入数据应采用可迭代的taggeddocuments格式”
- 每个 taggeddocument 实例都包含单词和标签
- 因此,每个文档(即句子或段落)应该有一个可识别的唯一标签
for i in range(len(sentences)):
    sentences[i] = [word.lower() for word in sentences[i] if re.match('^[a-za-z]+', word)]
print(sentences[0])    # title, author, and year
print(sentences[1])
print(sentences[10])
['the'、'悲剧'、'of'、'哈姆雷特'、'by'、'威廉'、'莎士比亚']
['actus', 'primus']
['弗兰']
for i in range(len(sentences)):
    sentences[i] = taggeddocument(words = sentences[i], tags = ['sent{}'.format(i)])    # converting each sentence into a taggeddocument
sentences[0]
taggeddocument(words=['the', 'tragedie', 'of', 'hamlet', 'by', 'william', 'shakespeare'], tags=['sent0'])
创建和训练模型
- 创建 doc2vec 模型并使用 hamlet 语料库对其进行训练
- 关键参数说明(https://radimrehurek.com/gensim/models/doc2vec.html)
- 句子:训练数据(必须是带有标记化句子的列表)
- size:嵌入空间的尺寸
- sg: cbow 如果为 0,skip-gram 如果为 1
- 窗口:每个上下文所占的单词数(如果窗口
- 大小为3,考虑左邻域中的3个单词和右邻域中的3个单词)
- min_count:词汇表中包含的最小单词数
- iter:训练迭代次数
- workers:要训练的工作线程数量
model = doc2vec(documents = sentences,dm = 1, size = 100, min_count = 1, iter = 10, workers = pool()._processes)

model.init_sims(replace = true)
保存和加载模型
- doc2vec模型可以本地保存和加载
- 这样做可以减少再次训练模型的时间
model.save('doc2vec_model')
model = doc2vec.load('doc2vec_model')
相似度计算
- 嵌入单词(即向量)之间的相似度可以使用余弦相似度等指标来计算
model.most_similar('hamlet')
[('horatio', 0.9978846311569214),
('女王', 0.9971947073936462),
('莱尔特斯', 0.9971820116043091),
('国王', 0.9968599081039429),
('妈妈', 0.9966716170310974),
('哪里', 0.9966292381286621),
('迪尔', 0.9965540170669556),
('奥菲莉亚', 0.9964221715927124),
('非常', 0.9963752627372742),
('哦', 0.9963476657867432)]
v1 = model['king']
v2 = model['queen']

# define a function that computes cosine similarity between two words
def cosine_similarity(v1, v2):
    return 1 - spatial.distance.cosine(v1, v2)

cosine_similarity(v1, v2)
0.99437165260314941
文中关于的知识介绍,希望对你的学习有所帮助!若是受益匪浅,那就动动鼠标收藏这篇《使用 Python 进行词嵌入:docc》文章吧,也可关注golang学习网公众号了解相关技术文章。
 CSS 选择器备忘单
- 上一篇
- CSS 选择器备忘单
- 下一篇
- PHP 函数单元测试中的依赖关系管理
-
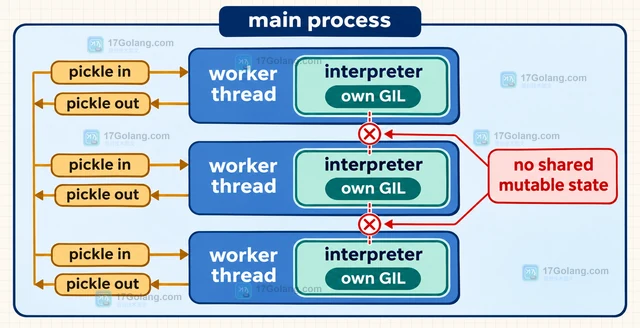
- 文章 · python教程 | 4小时前 | 并发 · 线程池 · python · Python concurrent.futures 多解释器 InterpreterPoolExecutor CPU并行
- Python concurrent.futures InterpreterPoolExecutor 适合什么任务
- 186浏览 收藏
-
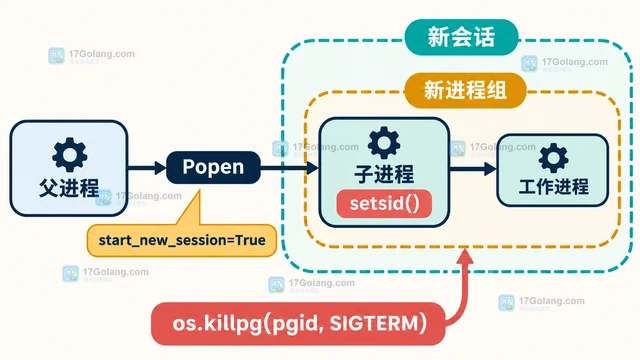
- 文章 · python教程 | 4小时前 | Python教程 · 进程管理 · Python subprocess.Popen TimeoutExpired 进程组 start_new_session killpg
- Python subprocess.Popen start_new_session 怎样清理进程组
- 340浏览 收藏
-
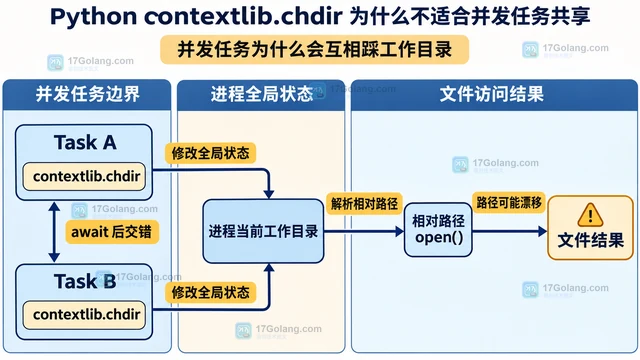
- 文章 · python教程 | 4小时前 |
- Python contextlib.chdir 为什么不适合并发任务共享
- 241浏览 收藏
-
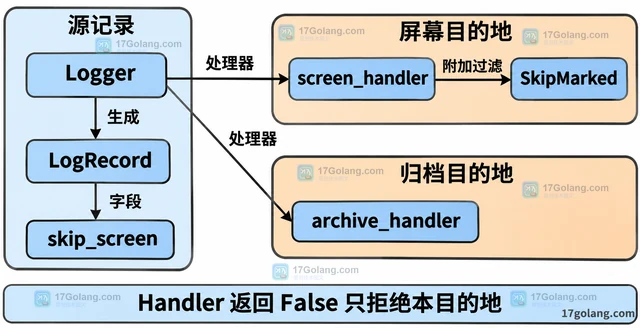
- 文章 · python教程 | 4小时前 | Python handler 日志过滤 logging.Filter
- Python logging.Filter 返回 False 时怎样阻止单条记录
- 447浏览 收藏
-
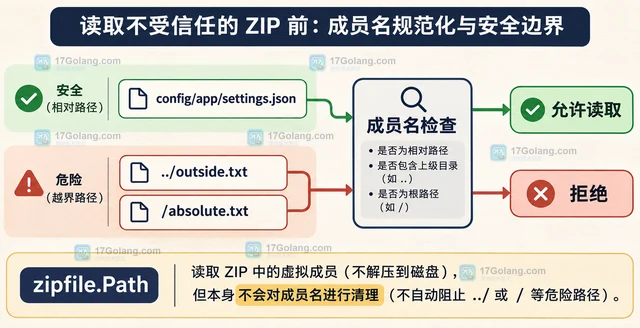
- 文章 · python教程 | 4小时前 |
- Python zipfile.Path 怎样读取压缩包内的嵌套资源
- 157浏览 收藏
-
- 文章 · python教程 | 5小时前 | 协程 · 任务调度 · Python教程 · asyncio · 兼容性 · Python asyncio 异步调度 create_task eager_start
- Python asyncio.create_task eager_start 如何影响调度
- 155浏览 收藏
-
- 文章 · python教程 | 5小时前 | Python CancelledError TaskGroup asyncio.timeout 嵌套超时
- Python asyncio.timeout 怎样把嵌套任务限制在总时限内
- 215浏览 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 485次学习
-

- PubMedQA
- 深入了解PubMedQA生物医学问答数据集,涵盖其核心功能、使用方法及在临床决策、药物研发等场景的应用,助力提升NLP模型性能。
- 1020次使用
-

- H2O EvalGPT
- H2O EvalGPT是H2O.ai推出的开源LLM评估平台,提供详细的大模型性能排行榜、行业特定基准测试及A/B测试功能,助您快速选择最适合项目的高性能大语言模型。
- 1022次使用
-

- LMArena
- LMArena是加州大学伯克利分校推出的AI模型匿名评测平台。通过盲测投票机制,用户可对比不同大模型回答并生成实时排行榜,助力开发者优化模型及用户选择最佳AI工具。
- 1160次使用
-

- HELM
- 深入了解斯坦福推出的HELM(Holistic Evaluation of Language Models)大模型评测体系。本文解析其核心功能、安装配置步骤及应用场景,涵盖准确性、公平性、鲁棒性等多维度指标,助力开发者全面优化语言模型性能。
- 1123次使用
-

- MMBench
- MMBench是由上海人工智能实验室等机构联合推出的多模态基准测试平台,提供细粒度能力评估、大规模数据集及VLMEvalKit工具。本文详细介绍其核心功能、安装使用方法及应用场景,助力开发者全面评估多模态模型性能。
- 965次使用
-
- Python TaskGroup 怎样让子任务失败统一收敛
- 2026-11-12 501浏览
-
- Python xml.dom.minidom.unlink 怎样释放不再使用的 DOM 树引用
- 2026-10-27 501浏览
-
- Python typing 怎样用 TypeIs 缩小类型
- 2026-10-24 501浏览
-
- Python sqlite3 Connection serialize 怎么导出数据库快照:备份窗口、内存占用与恢复校验
- 2026-08-26 501浏览
-
- Python监控网页状态:requests异常处理实战
- 2026-05-29 501浏览


