详细介绍
Whisper:OpenAI开源的多语言自动语音识别系统
Whisper是由OpenAI开发并开源的神经网络,专注于英语语音识别,并在多语言处理上表现出色。它通过从网络收集的680,000小时的多语言和多任务监督数据进行训练,旨在提供接近人类的鲁棒性和准确性。
核心优势:
- 多语言支持:Whisper能够处理多种语言的语音识别和翻译,提升了跨语言沟通的便利性。
- 鲁棒性强:其训练数据集包含各种口音、背景噪音和技术术语,确保在复杂环境下的高识别准确性。
- 端到端架构:采用编码器-解码器Transformer模型,简化了处理流程,提高了效率。
- 零样本学习能力:即使在没有针对特定数据集进行微调的情况下,Whisper也能展现出优异的零样本性能。
主要功能:
- 语言识别:自动识别音频中的语言,为后续处理提供基础。
- 转录和翻译:不仅能转录原始语言的语音,还能将非英语音频翻译成英语,满足多语言需求。
- 特殊标记处理:通过特殊标记,Whisper能够执行语言识别、短语级时间戳、多语言语音转录和英语语音翻译等多项任务。
应用场景:
假设您有一段包含多种语言的音频文件,您可以使用Whisper:
- 将音频分割成30秒的片段。
- 将每个片段转换为对数Mel频谱图。
- 使用Whisper模型进行语音识别,得到文本转录。
- 如果需要,还可以将文本从原始语言翻译成英语。
总结:
Whisper作为一个开源的多语言自动语音识别系统,通过大规模和多样化的数据集训练,显著提升了在复杂环境下的语音识别能力。其开源特性为开发者和研究人员提供了丰富的应用和研究基础,Whisper的鲁棒性和多语言处理能力使其在语音识别领域具有广阔的应用前景。
查看更多
最新文章
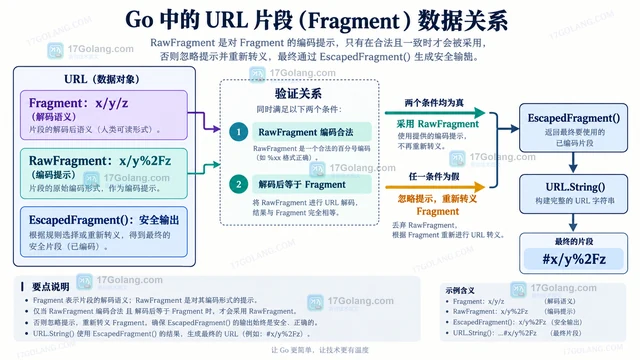
Go url.URL EscapedFragment 保留片段编码的输出方式
Go 的 URL.Fragment 保存解码语义,RawFragment 仅是原始编码提示。本文说明 E
照妖镜文字计数怎么用?创作工具与字数评估场景说明
照妖镜产品站把灵感便签、配色助手和文字计数放在创作场景中,本文按公开页面说明它们的分工、适用任务与使用边
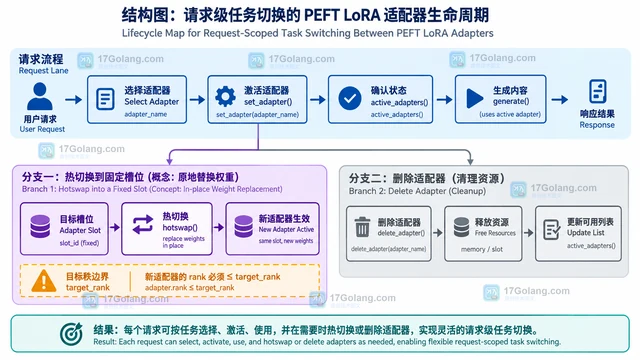
PEFT LoRA 适配器按任务切换的加载方案
在同一个基础模型上预加载多个 PEFT LoRA 适配器,使用唯一名称和 set_adapter 按任务
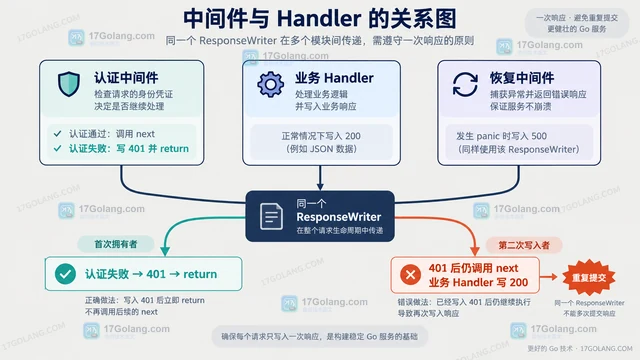
Go HTTP 中间件重复写响应头的定位方法
Go HTTP 中间件重复写响应头,通常是前一层已提交错误响应却仍调用后续处理器。本文从提交边界、调用链
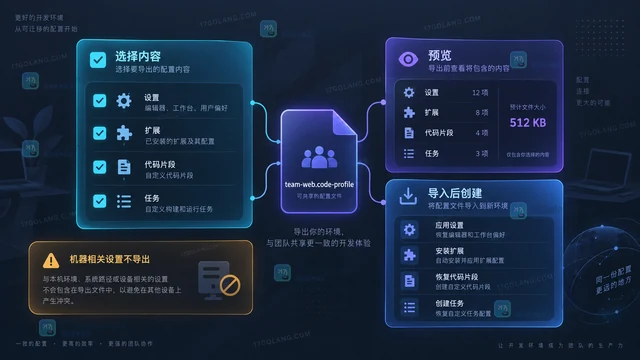
VS Code profiles 按项目隔离扩展与设置
VS Code Profiles 可把扩展、用户设置、快捷键和界面布局组成独立配置,并自动关联项目。本文
photocolors能做什么?旅行照片、穿搭灵感与品牌配色场景说明
photocolors产品站展示了照片主色提取、色盘记录和记忆卡片两类能力,本文按旅行、穿搭与设计参考等