详细介绍
Vary-toy:小型视觉语言模型,开启视觉AI新时代
Vary-toy是由MEGVII Technology、中国科学院大学和华中科技大学的研究人员共同开发的一款小型视觉语言模型(LVLM)。它专为资源有限的研究者和开发者设计,旨在解决大型视觉语言模型在训练和部署上的挑战。
核心优势:
- 小尺寸,大能量:Vary-toy体积小巧,适合在消费级GPU上进行训练和部署,让更多研究者能够轻松上手。
- 功能全面,应用广泛:尽管尺寸小,Vary-toy却具备与大型模型相媲美的功能,如文档OCR、图像描述、视觉问答等,满足多样化的需求。
- 视觉词汇网络优化:通过改进的视觉词汇网络,Vary-toy能够更高效地编码自然物体的视觉信息,提升模型的理解能力。
强大功能:
- 文档级光学字符识别(OCR):精准识别文档中的文字,并可转换为Markdown格式,提升文档处理效率。
- 图像描述:自动生成对图像内容的详细描述,帮助用户快速理解图像信息。
- 视觉问答(VQA):与图像内容相关的问答互动,提供智能的视觉理解和回答。
- 对象检测:识别并定位图像中的各个对象,应用于多种场景。
- 图像到文本的转换:将图像内容转换为文本,方便信息提取和处理。
- 多模态对话:支持与用户进行自然的多模态对话,增强用户体验。
应用场景:
- 对象检测:
- 用户上传图片,Vary-toy能够快速识别并标注图中的各个对象,适用于图像分析和数据标注。
- OCR图像转文本/Markdown:
- 用户上传PDF图像,Vary-toy提供精准的OCR结果,并可转换为易于编辑的Markdown格式,提升文档处理效率。
- 日常对话:
- 用户与Vary-toy进行日常对话,模型能够理解图像内容并生成相关对话,增强人机交互体验。
总结:
Vary-toy作为一款小型但功能强大的视觉语言模型,为资源有限的研究者和开发者提供了先进的视觉语言模型功能。通过改进的视觉词汇网络和多任务预训练策略,Vary-toy在保持小尺寸的同时,展现出处理复杂视觉语言任务的强大能力。无论是文档处理、图像分析还是多模态对话,Vary-toy都能为您带来高效、便捷的解决方案。
查看更多
最新文章
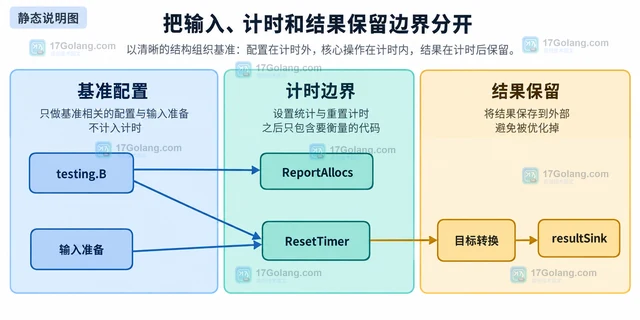
Go Benchmark报告allocs/op并定位临时对象来源的方法
用 go test -benchmem 和 testing.B.ReportAllocs 读懂 B/op
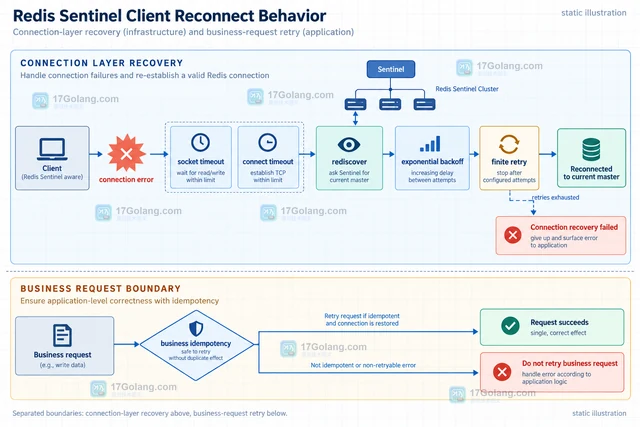
Redis Sentinel故障转移期间客户端重连的配置方法
Redis Sentinel故障转移时,客户端不能继续依赖旧主节点地址。本文以服务发现、连接池、超时、退
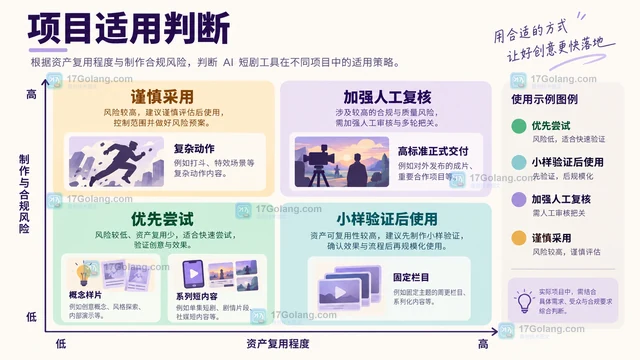
商汤Seko能做AI短剧工具吗?功能范围和适用场景
本文解答商汤Seko作为AI短剧工具的核心能力,拆解功能边界、适用场景与选型要点,为创作者和工作室提供实
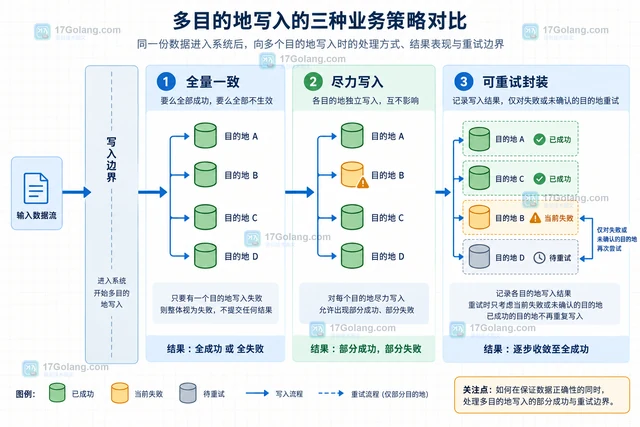
Go MultiWriter第一个Writer失败后其他Writer未完成的处理边界
Go io.MultiWriter按顺序写入多个Writer,首个错误会截断后续目标。本文用故障示例拆解
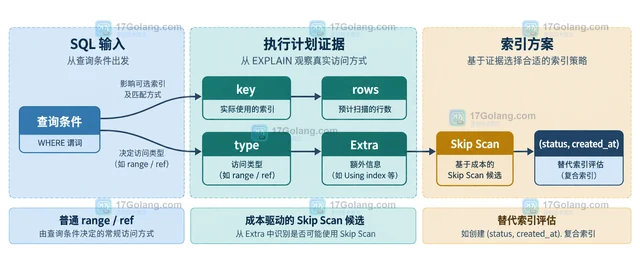
MySQL 复合索引跳过最左列时的访问边界
围绕 (tenant_id, status, created_at) 示例,说明跳过复合索引最左列后普通
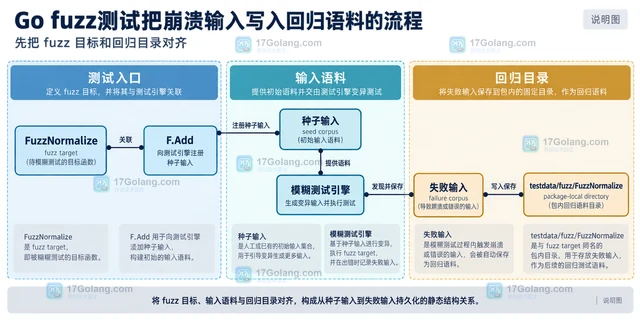
Go fuzz测试把崩溃输入写入回归语料的流程
Go fuzz 测试发现崩溃输入后,如何利用 testdata/fuzz 语料目录在普通 go test